
O problema que ninguém resolveu até agora
A reconstrução por IA a partir de fMRI sempre prometeu muito e entregou pouco. Você deitava no scanner, olhava para uma banana e o modelo gerava qualquer banana genérica, em outra posição, com outra luz, outro contexto. Era classificação disfarçada de reconstrução. O trabalho novo do Instituto Weizmann muda esse jogo porque ataca exatamente onde os outros falhavam: estrutura espacial. Não basta acertar o que é, é preciso acertar onde está, com que forma e com que relação entre os objetos. E, pelos pares de imagens divulgados, eles chegaram bem mais perto disso do que qualquer tentativa anterior.
Eu testo modelos generativos toda semana e sei reconhecer quando um avanço é só demo bonita. Aqui tem algo diferente. O modelo não apenas gera uma imagem plausível a partir da atividade cerebral, ele também faz o caminho inverso e prevê a atividade cerebral a partir da imagem. Essa bidirecionalidade importa porque sugere que o sistema aprendeu um mapeamento mais real entre visão e cérebro, não apenas um truque de prompt visual. Ainda está longe de ler pensamentos, mas está perto o suficiente para a gente precisar falar sério sobre custo, limite técnico e privacidade.
O fato, sem hype
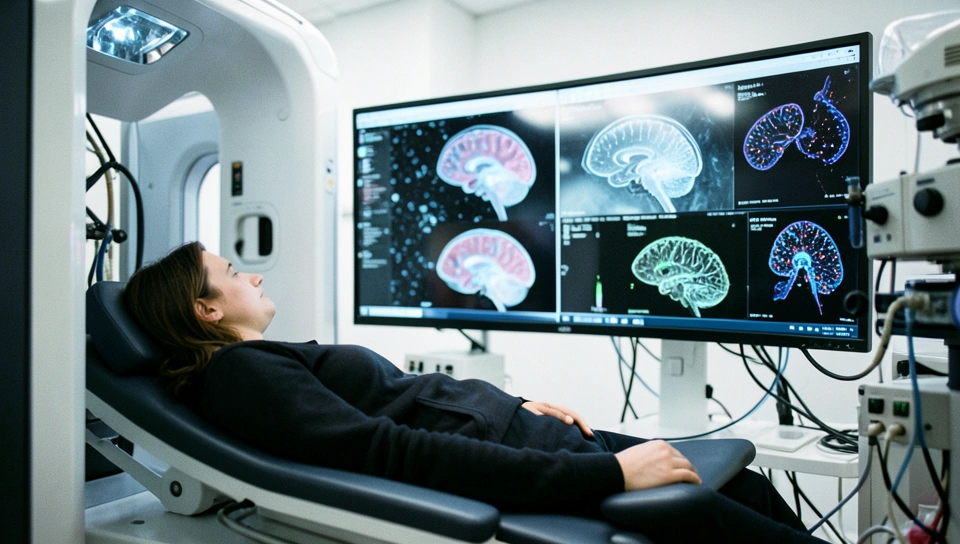
Pesquisadores liderados por Michal Irani desenvolveram um decodificador cerebral treinado com dados de oito pessoas que viram cerca de 9 mil imagens cada uma dentro de um scanner de fMRI de alta resolução. Enquanto os voluntários observavam as fotos, o scanner registrava o fluxo de sangue oxigenado no córtex visual. Depois, a IA aprendia a associar aquele padrão de ativação com a imagem correspondente e tentava reconstruí-la do zero apenas a partir do sinal cerebral.
O resultado são reconstruções que preservam posição, layout e conteúdo com fidelidade inédita para esse tipo de tarefa. Se a pessoa viu um conjunto de bananas sobre um prato no canto esquerdo, o modelo não gera apenas uma banana aleatória no centro. Ele tenta recriar a cena. A proposta futura, segundo a equipe, é usar a mesma lógica para ajudar pessoas em estado de locked-in a se comunicar e, mais adiante, explorar imagens mentais internas e até conteúdo de sonhos. É uma ambição enorme, e os próprios neurocientistas fora do projeto dividem-se entre chamar isso de magnífico e de preocupante.
Como funciona, na visão de quem opera
Pense nessa ferramenta como dois encoders trabalhando em paralelo antes de um diffusion model. Essa é a sacada arquitetural. Um ramo prevê estrutura: bordas, posição, manchas de cor, layout espacial. O outro prevê conteúdo semântico: é banana, é rosto, é rua, é prato. Separar as duas coisas faz sentido porque o cérebro também separa. O córtex visual primário cuida muito de orientação e posição, enquanto áreas mais altas cuidam de categoria e significado. Ao tratar os dois fluxos de forma explícita, o modelo evita aquele efeito de gerar a categoria certa no lugar errado.
Estrutura mais conteúdo mais difusão
Na prática, o pipeline deve funcionar assim: o sinal de fMRI entra como um volume 3D de voxels, cada voxel cobrindo cerca de 1 milímetro cúbico nessa nova geração de scanners, contra 3 milímetros dos equipamentos comuns. Isso ainda é grosseiro, estamos falando de cerca de milhares de neurônios por voxel, mas é três vezes melhor em cada eixo, o que dá muito mais detalhe espacial. Esse volume é alinhado, normalizado e passado pelos dois preditores. As saídas condicionam um modelo de difusão, aquele mesmo tipo que cria imagens limpando ruído aos poucos, que então reconstrói a cena.
Sobre custo e latência, ninguém divulgou números de inferência, mas dá para inferir. fMRI de alta resolução não é API que você chama por centavos. É hora de máquina de ressonância magnética de pesquisa, que custa milhares de dólares por sessão, exige que a pessoa fique imóvel por dezenas de minutos e gera gigabytes por sujeito. O treino exige alinhamento individual, porque cada cérebro é um cérebro. O modelo foi treinado por sujeito, não é um decodificador universal plug and play. Para rodar, você precisa de GPU parruda para difusão mais pré-processamento pesado de neuroimagem. Latência realista fica em segundos a minutos por reconstrução, não em tempo real. Funciona no laboratório, não escala para o mundo ainda.
O que isso muda na prática
Quem ganha no curto prazo é a pesquisa básica em neurociência. Ter um decoder que respeita estrutura permite testar hipóteses sobre como o cérebro codifica espaço e objeto de forma separada. Para aplicação clínica, o potencial é real para pacientes com ELA, AVC de tronco ou outras condições que travam a comunicação motora. Se a pessoa consegue ver e prestar atenção, mesmo sem mover um músculo, um sistema desse tipo poderia um dia reconstruir o que ela está focando. Estamos falando de anos de validação, mas a direção é promissora.
Quem perde, por enquanto, é quem esperava um wearable de leitura mental. Isso não roda em EEG de pulseira, não roda em capacete barato, não roda sem consentimento cooperativo dentro de um magneto gigante que faz um barulho absurdo. O gargalo continua sendo o sensor, não o modelo. A IA melhorou muito, o hardware de captura continua caro, imóvel e sensível a qualquer movimento de cabeça de dois milímetros.
- Ação prática se você constrói com IA: se você trabalha com multimodalidade, estude essa separação entre estrutura e semântica. Ela vale para outros problemas, como gerar layout fiel em design, manter consistência espacial em vídeo ou condicionar difusão com mapas pobres. E se você trabalha com saúde, comece agora a desenhar protocolos de consentimento para dados neurais, porque o debate sobre privacidade mental vai chegar antes da tecnologia ficar barata.
A tensão que ninguém quer encarar
Aqui está o ponto incômodo. O avanço técnico é legítimo, mas ele move o gargalo em vez de resolvê-lo. Antes, podíamos dizer que a reconstrução era ruim demais para ser perigosa. Agora ela está ficando boa o suficiente para ser desconfortável, mesmo ainda exigindo um scanner de milhões. Tommy Sprague resumiu o medo: se houver um caminho para extrair o que você está pensando de forma sorrateira, 50 anos de ficção científica viram risco real. Judy Illes, neuroeticista, vê o lado terapêutico como tremendamente animador. As duas coisas são verdade ao mesmo tempo.
Minha dúvida de operador é simples e chata: isso escala sem virar vigilância? Hoje precisa de cooperação total, treino por indivíduo com milhares de imagens e equipamento que não cabe no bolso. Isso protege a privacidade por inviabilidade econômica. Mas sensores melhoram, modelos precisam de menos dados a cada ano e a história da tecnologia mostra que o que hoje exige laboratório amanhã cabe numa clínica. Não estamos no momento de pânico, estamos no momento de definir regras. Quem é dono do seu padrão de voxel? Pode uma seguradora, um empregador ou um tribunal pedir seu decoder cerebral? Sem resposta clara para isso, cada ganho de fidelidade aumenta o risco proporcionalmente.
Para fechar
É a primeira vez que uma reconstrução a partir de cérebro parece reconstrução de verdade, com lugar e coisa juntos, e não só um chute semântico bem renderizado. Resta saber se vamos usar isso para devolver voz a quem perdeu o corpo, ou para abrir a última fronteira privada que ainda nos resta.
Comentários
0 comentáriosNenhum comentário ainda. Seja o primeiro a comentar.