
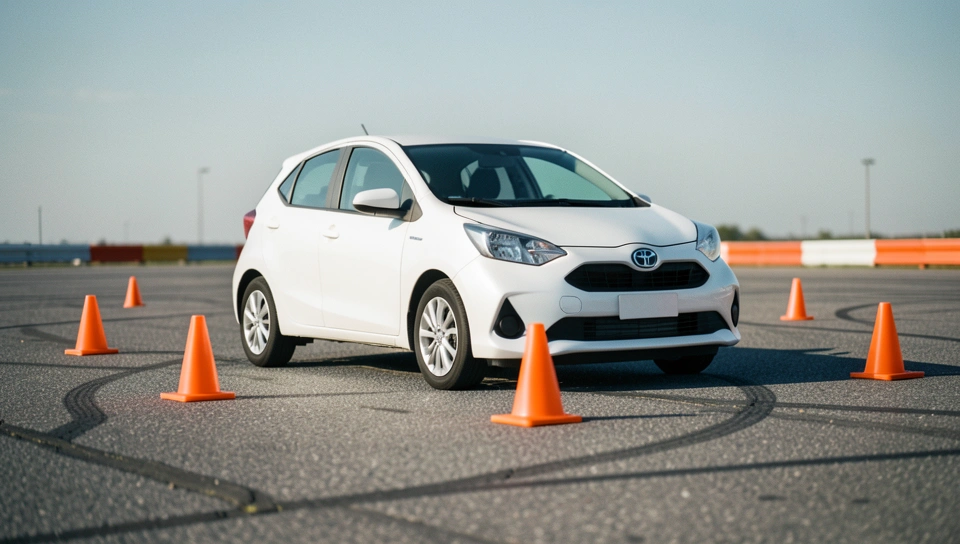
GPT-6 Astra no volante de um Toyota Corolla de verdade não é metáfora. No benchmark DrivingBench, o modelo assumiu direção, acelerador e freio em um circuito fechado de cones e completou 100% do percurso em 5 minutos e 22 segundos. Não é rua aberta, não é trânsito com moto cortando pela direita, mas é física real, com inércia, atraso de atuador, pneu que escorrega e GPS que oscila. E é por isso que o resultado incomoda. Se um modelo de linguagem consegue fechar uma volta sem bater, onde termina o chatbot e começa o motorista.
O teste foi simples de entender e difícil de executar. Nada de simulador. O carro responde a comandos enviados pelo modelo durante uma conversa contínua, com até três tentativas para completar o mesmo traçado. Cada tentativa é medida por progresso ao longo da linha central, distância percorrida, tempo, número de comandos aceitos e tokens consumidos. Colidiu, parou de contar. Saiu mais de 4 metros da linha, perdeu progresso. É avaliação de corpo inteiro, não de resposta certa em prova de múltipla escolha.
O fato, sem hype
O que aconteceu foi uma comparação direta entre modelos de fronteira colocados no mesmo carro, na mesma pista, com a mesma interface. O GPT-6 Astra, operando via Codex em modo medium, fez 49% na primeira tentativa, chegou a 100% na segunda e repetiu a lógica na terceira, com tempo final de 5:22. Nenhum outro modelo chegou perto de completar. O Claude Fable 5.1, via Claude Code, atingiu 45% como melhor marca, com outras tentativas em 9% e 10%. O Grok 4.6, via Cursor, ficou nos 11% de melhor progresso. O GPT-5.6 Sol, também via Codex, travou nos 6%.
Esses números importam porque mostram um abismo, não um empate técnico. Não foi todo mundo bem com pequena diferença. Foi um modelo que aprendeu a se corrigir entre tentativas e outros que repetiram o mesmo erro de posicionamento, de esterço ou de dosagem no acelerador. Em robótica, 45% contra 100% não é detalhe. É a diferença entre parar no meio da pista e conseguir retornar para o box. E 5:22 para um circuito de cones indica condução extremamente cautelosa, quase passo a passo, nada parecido com um piloto humano.
Como funciona na visão de quem opera
Pelo que foi exposto, a arquitetura é conversa como camada de controle. O modelo recebe observações da pista, provavelmente posição por GPS, velocidade, imagem ou estado simplificado, e responde com chamadas como set_motion para definir esterço e velocidade alvo, e stop_now para parada imediata. Cada comando aceito conta, cada reflexão após a tentativa consome tokens e entra no custo total. É um loop lento de perceber, decidir e agir, rodando sobre uma API de chat, não sobre um controlador de tempo real de 50 Hz.
Isso explica o tempo alto e a diferença entre os modelos. Um LLM opera com latência de centenas de milissegundos a poucos segundos por decisão, dependendo do tamanho do contexto e da infraestrutura. Para um carro a 15 km por hora, um segundo de atraso significa mais de 4 metros percorridos no escuro. Então o modelo precisa dirigir de forma defensiva, com comandos curtos, correções frequentes e margem de erro grande. Minha inferência técnica, e aqui é inferência, não dado oficial, é que o GPT-6 Astra se saiu melhor porque gerenciou melhor esse atraso. Ele deve ter usado sequências menores de movimento, esperou confirmação do estado antes de acelerar de novo e usou a reflexão entre tentativas para ajustar pontos de esterço. Os outros parecem ter oscilado, mandando comando demais ou de menos, e saindo da janela de 4 metros que define o progresso válido.
Custo é o outro lado que ninguém mostra no vídeo. Cada tentativa queima tokens com observação, raciocínio e reflexão. Uma volta de mais de cinco minutos com dezenas de comandos pode facilmente custar alguns dólares por tentativa em preços de tabela, sem contar carro, pista, equipe e seguro. Para pesquisa é ok. Para produto, essa conta não fecha se você precisar de inferência contínua para manter o carro na faixa. O modelo não está rodando embarcado, está provavelmente na nuvem, dependente de rede estável, o que adiciona jitter e risco.
O que isso muda na prática
Quem ganha com isso agora não é montadora, é quem constrói agentes para o mundo físico. O DrivingBench prova que dá para plugar um modelo de fronteira em atuadores reais com uma interface mínima de movimento e obter comportamento emergente de navegação. Isso reduz a barreira para protótipos de robôs móveis, empilhadeiras em galpão, cortadores de grama, inspeção em pátio. Você não precisa de um stack completo de direção autônoma para testar uma ideia de navegação por linguagem. Precisa de um veículo com drive by wire seguro, um circuito isolado e um logger decente.
Quem perde, por enquanto, é quem esperava autonomia geral. Nenhum desses modelos está pronto para rua. Progresso de 11% ou 6% em cones parados mostra que a maioria dos LLMs ainda não entende espaço, velocidade e consequência física de forma confiável. Eles alucinam trajetória, perdem referência e não recuperam bem depois do erro. Até o vencedor dirigiu devagar, com margem enorme, em ambiente controlado. Coloque pedestre, chuva e placa mal posicionada e esse stack de chat desmorona.
- Ação prática para quem está construindo: replique a lógica em escala pequena antes de pensar em carro. Pegue um carrinho RC com ROS, crie dois comandos simples equivalentes a set_motion e stop_now, logue latência de cada decisão, posição e comando aceito. Rode o mesmo percurso três vezes com o mesmo prompt e meça variação de trajetória. Se seu agente não completa um circuito de cones de 50 metros sem intervenção, ele não tem o que fazer em um carro de 1,5 tonelada.
Outro ajuste imediato é separar cérebro e reflexo. Use o LLM para plano de alto nível, como voltar para a linha central ou contornar o próximo cone pela esquerda, e deixe um controlador clássico executar o esterço em 20 Hz. Essa divisão resolve boa parte do problema de latência e mantém o custo sob controle, porque você chama o modelo poucas vezes por segundo, não a cada 50 milissegundos.
Isso escala ou só move o gargalo
Aqui fica minha dúvida real. Completar 100% é impressionante, mas a 5:22 em pista curta o sistema é mais um operador remoto hesitante do que um motorista. Se para ir mais rápido ele precisar de mais comandos por segundo, o custo e a latência explodem juntos. Aumentar a frequência de set_motion melhora a precisão, mas queima mais tokens e expõe o atraso da rede. Diminuir a frequência economiza, mas o carro anda no escuro por mais tempo. É um dilema clássico de controle, só que agora cobrado por token.
Também tem a questão da memória entre tentativas. O GPT-6 Astra melhorou de 49% para 100% dentro da mesma conversa. Isso sugere que a reflexão ajudou, mas até que ponto isso é aprendizado real de direção ou apenas memorização daquele circuito específico. Se trocar a ordem dos cones, mudar o piso ou adicionar vento lateral, ele mantém o desempenho ou volta para 40%. Benchmark de pista fixa sempre corre o risco de virar overfitting de demo. Resolver cones não prova que entendeu dirigir, prova que entendeu aqueles cones, naquele dia, naquele carro.
Conclusão
O DrivingBench tirou a discussão de IA que dirige do simulador e colocou no asfalto, com métricas claras de progresso, tempo e comandos. O GPT-6 Astra foi o único a fechar a volta, e isso merece atenção. Mas fez isso devagar, caro e com ajuda de reflexão entre tentativas. A pergunta que fica para quem opera é direta. Você quer um modelo que dirige por linguagem ou um sistema onde linguagem apenas supervisiona um controle que já funciona.
Comentários
0 comentáriosNenhum comentário ainda. Seja o primeiro a comentar.