
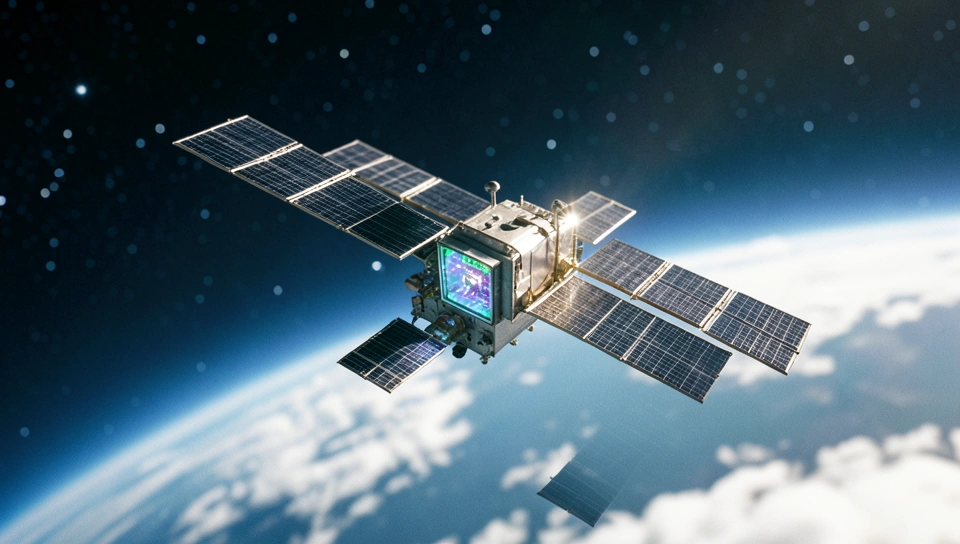
O teste saiu do papel e foi para a órbita
Data center orbital deixou de ser um slide bonito de futurista e virou hardware de verdade esta semana. O Google colocou um TPU em órbita para responder uma pergunta bem objetiva de operador: dá para rodar inferência de IA fora da Terra sem fritar o chip, sem estourar o orçamento de energia e sem perder o modelo no meio do caminho por causa de radiação. É um primeiro passo pequeno, um satélite só, mas ele expõe o tamanho do problema. O chip até funciona no espaço. Levar milhares deles para lá, com energia, refrigeração e rede entre eles, é outra história completamente diferente.
Quem opera infraestrutura de IA hoje vive preso no mesmo triângulo: energia, custo por watt e tempo para energizar um novo cluster. No solo, conseguir um gigawatt de energia firme leva anos, passa por licenciamento, subestação, água para resfriamento e briga com a rede local. No espaço, o sol é abundante e gratuito, não precisa de terreno e não tem vizinho reclamando do barulho. Parece perfeito no papel, e é exatamente por isso que o Google criou o Projeto Suncatcher. Só que a conta só fecha se o custo para subir massa despencar de um jeito que ainda não aconteceu.
O fato: um TPU em um satélite da Planet Labs
O protótipo decolou em um foguete da SpaceX lançado da Califórnia, em uma missão de carona com mais de cem cargas diferentes. O satélite foi construído sobre uma plataforma padrão da Planet Labs e carrega um TPU do Google, o acelerador próprio que compete com as GPUs da Nvidia. A missão agora é bem pragmática: comissionar o satélite, alimentar o chip com cerca de um quilowatt de potência contínua, manter a temperatura sob controle e rodar uma série de modelos para ver o que quebra primeiro.
Por enquanto o TPU vai operar em rajadas de cerca de 15 minutos para não forçar os sistemas de energia e dissipação térmica. É um limite importante porque mostra que não estamos falando de um servidor com ventoinha e água gelada. No vácuo não existe convecção, só radiação térmica, então cada watt vira um problema de engenharia. O plano seguinte já está desenhado: dois satélites mais dedicados a computação, previstos para voar no ano que vem, tentando se comunicar por link laser e operar de forma colaborativa. A visão de longo prazo é uma formação de 81 satélites voando próximos, processando em paralelo como se fossem racks de um mesmo data center.
Como funciona na visão de quem opera
Pensa na arquitetura como um rack que foi picado em pedaços e jogado a 500 quilômetros de altura. Cada satélite tem painel solar, bateria, um barramento de potência limitado, radiadores para jogar calor fora e um computador de bordo que precisa sobreviver a partículas de alta energia. O TPU não foi feito para isso. Ele foi feito para um galpão com piso elevado, com resfriamento líquido e energia estável. No espaço, qualquer variação de tensão, qualquer ponto quente e qualquer bit flipado por radiação pode corromper uma inferência ou travar o acelerador.
O Google refez testes de radiação em acelerador de partículas depois de perceber que a primeira configuração dava proteção extra que não existiria na operação real. O resultado, segundo a pesquisa atualizada, foi um pouco mais de erros na lógica do chip, mas ainda dentro de uma faixa que a empresa considera administrável. Para quem opera, isso se traduz em uma inferência plausível: data center orbital vai exigir redundância, checkpoint frequente, repetição de cálculos críticos e modelos tolerantes a falha. Não dá para tratar como um endpoint determinístico de API. Vai ser preciso pensar em taxa de erro silenciosa, em reexecução e em latência adicional por causa dessa checagem.
Tem ainda o ponto mais sensível para escala: rede entre TPUs. Treinamento distribuído e mesmo inferência em larga escala com paralelismo exigem largura de banda altíssima e latência baixíssima entre aceleradores. No solo isso se resolve com NVLink, InfiniBand, fibra curta e switches caros. Em órbita, a proposta é usar comunicação óptica entre satélites em formação próxima. Funciona no laboratório, mas manter apontamento laser estável entre plataformas que se movem a 7,5 quilômetros por segundo, vibram e sofrem dilatação térmica, é um desafio de controle fino. Se o link oscilar, o throughput do cluster inteiro cai e a latência de cauda explode. É o tipo de coisa que transforma um cluster teoricamente potente em um sistema que vive esperando dado.
O que isso muda na prática
No curto prazo, nada muda no seu bill da nuvem. Ninguém vai migrar workload para órbita em 2026. Quem ganha agora são os times que fornecem a base: fabricantes de barramento de satélite, fornecedores de link óptico, empresas de teste de radiação e as equipes dentro do Google que estão aprendendo a operar TPU fora do ambiente controlado. Quem perde, por enquanto, são as startups que venderam data center espacial como algo para daqui a dois anos. O recado do Google é claro: isso é um moonshot de longo prazo, mirando nas cargas e na infraestrutura de daqui a cinco anos, não nas filas de GPU de hoje.
- Mapeie seu envelope de energia por milhão de tokens: meça hoje quanto seu modelo consome em watts por inferência e qual temperatura ele gera em pico, porque esse será o primeiro filtro para qualquer carga candidata a operar com restrição severa de potência.
- Teste tolerância a falha silenciosa: rode inferência com injeção de erro e repetição de lote para ver onde seu pipeline quebra, porque operação orbital vai exigir reexecução e validação sem travar a API.
- Acompanhe custo por quilo lançado, não só custo por token: crie um indicador interno que cruza preço de lançamento, massa por petaflop e eficiência térmica, assim você saberá quando a órbita deixa de ser marketing e vira alternativa.
Para times de plataforma, a ação mais útil é separar workloads que toleram latência de ida e volta ao espaço daquelas que precisam de resposta local imediata. Processamento batch, pré-treinamento de partes específicas, inferência assíncrona e observação da Terra com IA embarcada fazem mais sentido inicial do que chatbot em tempo real. Se seu produto depende de 50 milissegundos garantidos, órbita não é para você tão cedo.
O gargalo real: foguete, não chip
Aqui entra a parte que mais esfria o hype. Junto com o lançamento, o Google liberou uma versão revisada por pares do seu white paper sobre data centers orbitais, que será publicada na revista Joule. É uma das análises mais rigorosas já feitas sobre como levar computação para órbita. E o ponto central não é física do chip, é logística de lançamento. Os autores partem da ideia de que a SpaceX tem uma curva de aprendizado de cerca de 20 por cento ao ano em redução de custo desde o Falcon 1, e projetam que seria razoável chegar perto de 200 dólares por quilo até 2035.
Para chegar nesse preço, pela conta deles, seria preciso lançar algo como 370 mil toneladas de carga com Starship, o equivalente a cerca de 1.800 voos em dez anos, ou 180 por ano, considerando 200 toneladas métricas por missão. É um número brutal quando lembramos que a Starship nunca voou mais de cinco vezes em um ano. Elon Musk fala em cadência horária em 2029, mas promessa de cadência não paga massa em órbita. Entre a curva teórica de aprendizado e a realidade de plataforma de lançamento, licenciamento, produção de motores, reuso rápido e logística de propelente, existe um abismo operacional. O TPU sobreviver à radiação era a parte fácil. Escalar lançamento reutilizável pesado para ritmo de linha aérea é a parte que ninguém provou.
E mesmo se o foguete escalar, o problema só muda de lugar. Energia solar no espaço é abundante, mas rejeitar calor no vácuo é péssimo. Cada quilowatt de computação vira quilowatt de calor que precisa de área de radiador, e radiador é massa, e massa é lançamento. Some a isso manutenção impossível, sem técnico para trocar uma placa, sem reboot físico, com degradação de painel e bateria ao longo dos anos. No solo o gargalo é conseguir energia e licenciar obra. No espaço o gargalo vira colocar massa, manter formação, apontar laser e não deixar o sistema cozinhar. Não é que um seja melhor, é que são difíceis de jeitos diferentes.
Conclusão
O Google provou que dá para ligar um TPU em órbita e rodar modelos em rajadas curtas, e isso é um marco técnico real. Mas a viabilidade de data centers orbitais depende menos do chip e muito mais de a Starship voar centenas de vezes por ano a 200 dólares por quilo. Até lá, vale acompanhar como operador: funcionou uma vez, escala para mil vezes sem derreter a conta e a física?
Comentários
0 comentáriosNenhum comentário ainda. Seja o primeiro a comentar.