
O momento no palco
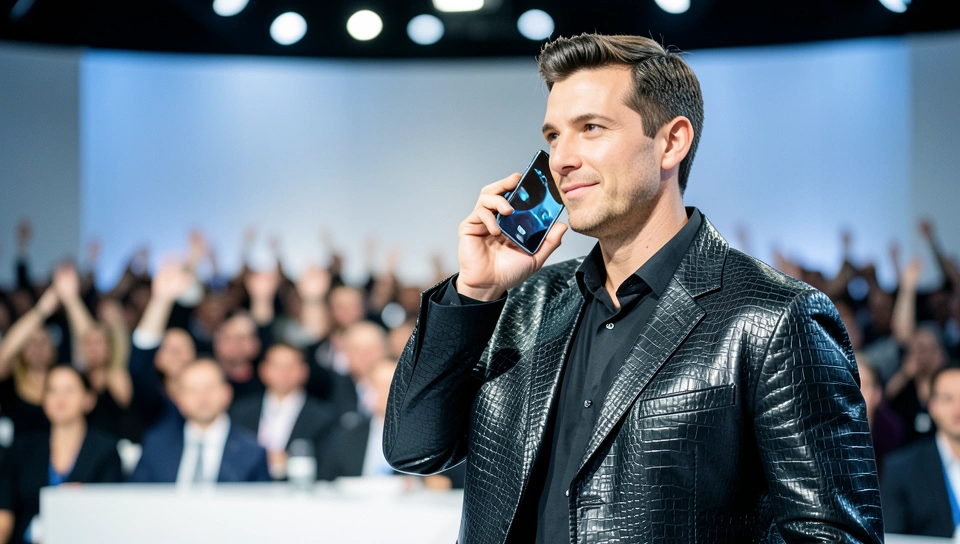
Nvidia, Trump e um iPhone dobrável que ainda nem chegou às lojas. Essa foi a combinação que apareceu ao vivo no palco da conferência All-In, em Los Angeles, quando Jensen Huang atendeu uma ligação do presidente americano na frente de milhares de pessoas. Parecia improviso, mas quem opera infraestrutura de IA sabe que nada ali foi por acaso. Havia um recado de poder, um teste de narrativa sobre segurança e um teaser de hardware de 1.999 dólares acontecendo na mesma cena, ao mesmo tempo.
No palco da All-In, Huang vestia sua já famosa jaqueta de couro de jacaré quando foi surpreendido pela chamada. Colocou Trump no viva-voz e a conversa rapidamente foi para segurança de IA. Trump disse que o medo em torno da tecnologia é um 'hoax', que os verdadeiros beneficiados do pânico são a China e gente da política, e que a IA é grande demais para ser freada, maior que a internet. Huang riu, disse que milhares estavam aplaudindo e seguiu o jogo. Para quem constrói, o incômodo foi imediato, porque segurança virou piada ao vivo enquanto o custo de computação continua subindo.
O fato sem hype
O fato direto é simples. Jensen Huang atendeu ao vivo uma ligação de Donald Trump durante um evento público e usou para isso um suposto iPhone dobrável da Apple, que só deve chegar às lojas daqui a cinco semanas. O aparelho foi entregue a ele no palco e ficou bem visível nas fotos e vídeos. Exibir um hardware não lançado enquanto fala com o presidente é um flex calculado, ainda mais vindo de alguém que raramente aparece com um celular alheio na mão.
O detalhe que quase ninguém comentou é o histórico. Faz uma década que a Apple rompeu com a Nvidia nos Macs, trocando CUDA e GPUs dedicadas por arquitetura própria e Metal. Agora, parte do Apple Intelligence precisa de treino pesado em clusters de GPUs, e esse treino ainda acontece majoritariamente em hardware da Nvidia. Ou seja, o recado não foi a ligação, foi o telefone. A Apple precisou da Nvidia para entregar IA, e a Nvidia fez questão de mostrar isso sem dizer uma palavra.
Como funciona na visão de operador
Na prática de operador, o que está em jogo aqui é arquitetura dividida. O Apple Intelligence roda em dois planos. Uma parte roda on-device, com modelos pequenos otimizados para tarefas de resumo, escrita e Siri, usando Neural Engine e memória unificada. A outra parte vai para a nuvem, no que a Apple chama de Private Cloud Compute, com promessa de privacidade e servidores com silício próprio. Só que antes de qualquer inferência bonita no palco, existe o treino, e treino de modelo de fundação ainda é território Nvidia, com H100, H200 e agora B200, com NVLink, memória HBM e custo de aluguel que facilmente passa de dois dólares por GPU por hora no mercado spot.
O dobrável muda a conta de latência e energia. Uma tela maior dobra a área de uso para multitarefa com IA, o que significa mais contexto visível, mais janelas, mais chamadas simultâneas ao modelo local. Isso pressiona largura de banda de memória, dissipação térmica e bateria. Um modelo on-device de 3 bilhões de parâmetros pode parecer leve no papel, mas em uso contínuo ele esquenta, drena e exige quantização agressiva para manter tokens por segundo aceitáveis. Minha inferência técnica, e deixo claro que é inferência, é que a Apple deve estar usando execução híbrida pesada nesse aparelho, com roteamento dinâmico. Se a pergunta é simples, resolve local. Se precisa de raciocínio longo, sobe para a nuvem. A latência alvo deve ficar abaixo de um segundo para tarefas curtas, o que exige pré-carregamento de modelo e cache agressivo.
Do lado Nvidia, a economia é ainda mais direta. A empresa não vende o telefone, ela vende as picaretas. Cada ponto percentual de adoção de IA generativa em iPhones se traduz em mais demanda por treino, fine-tuning e destilação de modelos no data center. Quando Trump diz que não se deve frear, ele está, na prática, defendendo capex contínuo. Para a Nvidia, que viu a ação subir cerca de 33% no último ano mesmo com uma queda pontual no dia do evento, esse discurso sustenta valuation. Não é filosofia, é pipeline de pedidos.
O que isso muda na prática
Quem ganha com essa cena é bem claro. A Nvidia ganha narrativa política e comercial ao mesmo tempo. A Apple ganha buzz global para um aparelho de quase dois mil dólares sem gastar um centavo em marketing, só deixando o telefone aparecer na mão certa. Os grandes labs ganham um sinal de que a Casa Branca não quer freio regulatório agora, o que mantém investimento fluindo. Quem perde são os times menores de segurança e avaliação, além de startups que apostavam em uma pausa ou em regulação dura para ter espaço. Se o risco vira 'hoax' no palco, fica mais difícil vender orçamento para red team, auditoria e alinhamento.
- Ajuste de capex: se você roda inferência própria, revise seu mix de GPU reservada contra on-demand, porque sinal político pró-escala costuma aquecer preço de aluguel nos próximos trimestres.
- Teste híbrido agora: replique a lógica Apple no seu produto, com modelo pequeno local para classificação e resumo e modelo grande na nuvem só para raciocínio, para cortar latência e custo por mil tokens.
- Observe o dobrável como plataforma: se a tela extra virar padrão para agentes, sua interface precisa funcionar em modo dividido, com contexto persistente e não só chatbot em tela única.
A ação prática mais imediata para quem constrói é simples. Rode esta semana um teste de custo por tarefa com e sem roteamento híbrido e meça latência p95, não média. A maioria dos times otimiza pela média e quebra no pico. Com hardware dobrável e agentes multitarefa chegando, o pico vai ser o normal. Se seu custo por mil chamadas subir mais de 20% ao ativar contexto longo, você ainda não está pronto para esse formato.
A tensão que ninguém quer admitir
Aqui entra a dúvida real. Huang concordou com Trump sobre segurança ou só não podia discordar ao vivo com milhares aplaudindo. Vamos ser honestos, o modelo de negócio da Nvidia depende de labs comprando mais chips a cada trimestre. Falar em risco existencial seria atirar no próprio faturamento. Ao mesmo tempo, ignorar avaliação séria cobra preço depois, em incidente, em processo, em perda de confiança. Isso escala sem governança ou só estamos empurrando o gargalo do treino para o gargalo da confiança. O custo compensa se o retorno em produtividade for real, mas até agora muito do ROI ainda é promessa em slide.
Tem outra tensão ainda mais incômoda. A Apple, que expulsou a Nvidia do Mac há dez anos por briga de controle de plataforma, agora depende dela para treinar os modelos que vão justificar um celular de 1.999 dólares. E a Nvidia, que domina o data center, depende da Apple para colocar IA na mão de dois bilhões de pessoas. É uma codependência cara, travada por margem, energia e geopolítica. Resolve o problema do usuário ou só move o poder de quem cobra o pedágio, do chip x86 de antes para a GPU de agora e para a taxa de nuvem depois.
Conclusão
No fim, a ligação era barulho e o telefone era o sinal. Fica a pergunta que importa para quem opera: se até a Apple precisa da Nvidia para entregar IA no bolso, qual é o seu plano quando o aluguel da inteligência subir de novo.
Comentários
0 comentáriosNenhum comentário ainda. Seja o primeiro a comentar.