
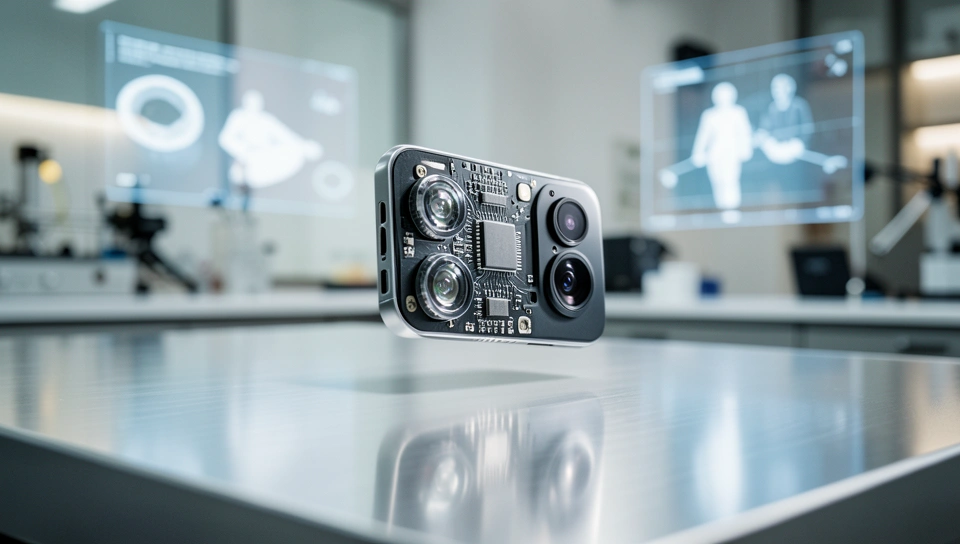
O celular limita a IA antes do modelo
OpenAI comprar uma empresa de câmera para smartphone parece estranho se você pensa em chatbots, mas faz todo sentido se você pensa como operador. O limite da IA multimodal hoje não está só no modelo, está na entrada. Lente pequena, sensor pequeno, ruído, falta de luz, aberração ótica. Você pode ter o melhor modelo de visão do mundo, se a imagem que chega é ruim, a resposta será ruim. A Glass Imaging ataca exatamente esse ponto, e é por isso que a OpenAI pagou mais de 300 milhões de dólares por ela segundo o Wall Street Journal. Não é sobre fotografia bonita, é sobre dar olhos melhores para a próxima geração de dispositivos.
Aquisição desse tamanho, dez vezes o valor captado pela startup, não acontece por curiosidade. Acontece quando uma empresa percebe que precisa controlar o hardware para destravar um caso de uso. E no caso da OpenAI, o caso de uso é claro: um dispositivo próprio que enxerga o mundo o tempo todo.
O fato
A OpenAI comprou a Glass Imaging, startup fundada em 2019 em Los Altos, na Califórnia, por um valor acima de 300 milhões de dólares. A empresa tinha levantado cerca de 30 milhões de dólares antes da venda. Os fundadores são Ziv Attar e Tom Bishop, dois ex-engenheiros da Apple que lideraram o time responsável pelo Portrait Mode do iPhone. Ou seja, não é um time qualquer de fotografia computacional, é o time que definiu como um celular borra fundo e separa planos com uma lente minúscula.
A Glass Imaging se diferencia porque não usa IA para editar a foto depois de pronta. Ela usa redes neurais para aprender as características de cada sistema de câmera, lente, sensor, ISP, e corrigir a imagem no momento da captura. Na prática, ela tenta reverter limitações físicas com software treinado para aquele hardware específico. A OpenAI não comentou oficialmente, mas o movimento se conecta diretamente aos rumores de que ela trabalha em smartphones, fones e dispositivos companheiros de IA, além da compra bilionária da io, startup de hardware de Sam Altman com Jony Ive em 2025.
Como funciona na visão de operador
Pensa na câmera do celular como um funil com perda. A luz entra por uma lente de poucos milímetros, bate num sensor pequeno, gera um arquivo RAW cheio de ruído e defeitos óticos, e aí o ISP tradicional aplica um pipeline fixo de demosaicing, redução de ruído, sharpening e compressão. Esse pipeline é genérico e conservador, feito para não quebrar em nenhum cenário. A proposta da Glass é trocar parte desse pipeline por um modelo neural calibrado por dispositivo.
O fluxo provável é mais ou menos assim: eles caracterizam a ótica de cada modelo de celular em laboratório, com charts, medidas de PSF, vignetting, aberração cromática e resposta do sensor em diferentes ISOs. Depois treinam uma rede que aprende a inverter esses defeitos e reconstruir detalhe real a partir do RAW, não a inventar textura como um upscaler genérico faz. Isso exige inferência pesada, provavelmente com destilação para rodar em NPU móvel ou com offload parcial para nuvem em cenários pro. Em termos de latência, estamos falando de dezenas a centenas de milissegundos por frame se for on-device, o que é aceitável para foto, mas ainda pesado para vídeo contínuo a 30 ou 60 fps.
Onde entra a aposta técnica
Aqui entra minha inferência como quem já quebrou a cabeça com visão em produção. A OpenAI não precisa de uma câmera melhor para Instagram, ela precisa de uma câmera melhor para agentes visuais. Modelos como o GPT-4o e sucessores dependem de frames limpos para fazer grounding, OCR, leitura de ambiente e memória espacial. Se a imagem tem ruído, o modelo alucina mais e erra distância, texto e objeto pequeno. Uma frente de correção ótica neural reduz essa taxa de erro antes do token chegar no modelo. É pré-processamento inteligente, e pré-processamento bom economiza tokens, reduz retry e corta custo de inferência.
Outro ponto é custo e arquitetura. Treinar um corretor por sensor parece caro e pouco escalável, mas faz sentido se você vai ter hardware próprio. Se a OpenAI controla uma ou duas câmeras, e não 200 modelos de Android, ela pode calibrar fundo, otimizar a rede para aquele SoC específico e embutir isso no silicon ou no firmware. Isso muda a conta de latência e bateria. Em vez de pagar computação na nuvem para limpar imagem ruim, você resolve na borda, uma vez, e alimenta um modelo menor e mais barato depois.
O que isso muda na prática
Quem ganha no curto prazo é quem constrói com visão computacional embarcada. Se a técnica da Glass virar padrão em um dispositivo OpenAI, a barra de qualidade de entrada sobe. Agentes que hoje falham com luz baixa, reflexo ou texto pequeno passam a funcionar. Quem perde são startups que vendiam melhoria de foto por prompt ou upscaling genérico pós-captura, porque a correção no RAW calibrado tende a ser mais fiel e mais barata no longo prazo do que ficar remendando JPEG depois.
- Para devs de apps visuais: a qualidade do input vai importar mais que o tamanho do modelo. Pipeline com RAW e correção específica tende a superar modelo maior comendo JPEG comprimido.
- Para fabricantes Android: pressão para sair do ISP tradicional e licenciar correção neural, ou ficar para trás em benchmarks de câmera com IA real.
- Para quem opera custo de VLM: imagem mais limpa significa menos crop, menos re-tentativa e prompt visual mais curto. Isso corta latência e conta no fim do mês.
A ação prática aqui é direta. Se você trabalha com leitura de documentos, inspeção, varejo ou robótica com celular, comece agora a separar seu pipeline em duas camadas: captura e interpretação. Teste capturar em RAW ou com o mínimo de processamento do fabricante, aplique denoising e restauração dedicados antes de mandar para o VLM, e meça taxa de acerto e custo por mil chamadas. Você vai se surpreender como uma imagem melhor permite usar um modelo mais barato sem perder precisão. E documente por dispositivo, porque iPhone 14 não enxerga igual a um Pixel intermediário, e seu agente precisa saber disso.
A tensão que ninguém quer admitir
Agora a parte incômoda. Isso escala de verdade ou só move o gargalo de lugar? Calibrar rede neural por sensor funciona bem quando você tem poucos dispositivos e controle total, como Apple faz. Mas o mundo Android é fragmentado, com centenas de combinações de lente e sensor. Manter modelos atualizados para cada variante, com QA ótico, é operação cara e lenta. A OpenAI pagou 300 milhões, mas o custo real está em manter essa máquina rodando, coletar dados de calibração e otimizar para cada NPU.
E tem o outro lado: resolver ótica com IA não cria detalhe do zero, ela reconstrói probabilidade do que deveria estar ali. Para foto casual, ótimo. Para agente que toma decisão no mundo físico, dirigir, identificar remédio, ler etiqueta de segurança, essa reconstrução precisa ser confiável, não bonita. Se o modelo inventar textura para agradar o olho, ele pode induzir o VLM ao erro. O risco é trocar ruído visível por alucinação invisível. Vale a pena? Provavelmente sim para um dispositivo fechado da OpenAI, onde ela controla hardware, modelo e avaliação ponta a ponta. Para o mercado aberto, ainda tenho dúvida se o custo de calibração compensa frente a simplesmente colocar sensor maior, que resolve na física o que hoje tentamos resolver no software.
Conclusão
No fim, a compra da Glass Imaging não é sobre câmera, é sobre controle da entrada para viabilizar hardware de IA que enxerga sempre. Se der certo, a OpenAI terá olhos melhores e mais baratos de operar que qualquer concorrente com modelo puro em nuvem. A pergunta que fica para quem constrói é simples: seu produto está pronto para um mundo onde a câmera não tira foto, ela entrega contexto limpo para o agente o tempo todo?
Comentários
0 comentáriosNenhum comentário ainda. Seja o primeiro a comentar.