
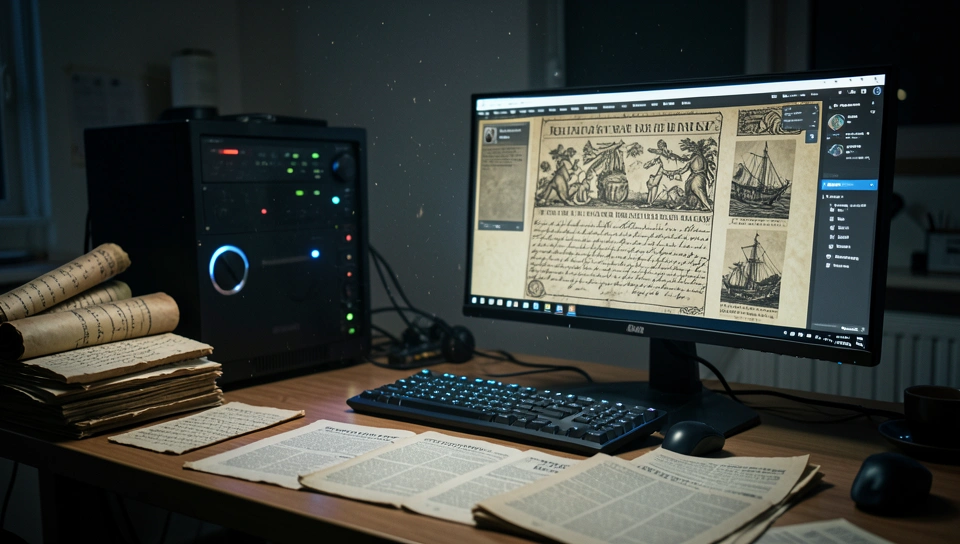
Buscar em arquivos históricos com IA parecia curiosidade acadêmica até alguém fazer a conta do tempo. Só as transcrições da Companhia Holandesa das Índias Orientais somam 4,35 milhões de páginas, do século XVII ao fim do século XVIII. A dois minutos por página, oito horas por dia, cinco dias por semana, um humano levaria cerca de 70 anos para ler tudo. Um pequeno laboratório caseiro com GPU fez isso em uma madrugada de 12 horas e saiu com um meteorito esquecido, três rinocerontes perdidos e erupções vulcânicas nunca registradas.
O ponto de partida foi simples e desconfortável para quem trabalha com dados. Temos milhões de páginas digitalizadas e transcritas, mas ninguém consegue perguntar nada a elas. A busca por palavra-chave quebra diante de caligrafia antiga, erro de OCR e ortografia instável. Rinoceronte aparece escrito de umas quinze formas diferentes no holandês do século XVII. Se você depende do termo exato, você perde quase tudo que importa.
O fato
No dia 1 de outubro de 2026, o historiador Benjamin Breen publicou um relato direto sobre o uso de um modelo Opus 5.5 para vasculhar o acervo digitalizado da Companhia Holandesa das Índias Orientais. O projeto GLOBALISE transformou milhões de páginas manuscritas em texto pesquisável. Breen encontrou no meio desse material um diário de bordo de 1615, nas Ilhas Maurício, em que marinheiros dizem ter capturado muitas tartarugas e dodôs. Um novo registro visual do dodô, extinto e famoso, parado à vista de todos por quatrocentos anos.
Um engenheiro de software leu o texto e decidiu ampliar a ideia. Em vez de buscar um mistério por vez, ele montou um pipeline para caçar vários em paralelo. Primeiro pediu a um assistente de pesquisa profunda que listasse perguntas históricas em aberto com maior chance de resposta em dados já disponíveis online. O filtro foi pragmático, com completude do acervo, acessibilidade, ajuda real que a IA poderia dar, originalidade e, principalmente, verificabilidade. Cada achado precisava terminar em um documento real, com scan do manuscrito ou do jornal e referência de arquivo que qualquer pessoa pode conferir. A lista final tinha treze candidatos, incluindo animais nos arquivos da Companhia, a erupção gigante de 1808 nunca localizada, terremotos sentidos em jornais holandeses antigos, quedas de meteoritos não registradas e navios desaparecidos.
Como funciona
O material de leitura juntou as transcrições do GLOBALISE, jornais digitalizados da Biblioteca Nacional da Holanda, dois séculos de jornais americanos e alguns diários de bordo. O truque não foi jogar tudo em um chat e torcer. Foi transformar o problema de leitura em problema de recuperação. A GPU local converteu cada trecho em uma espécie de impressão digital matemática do seu significado, o chamado embedding. Só do arquivo da Companhia foram 5,7 milhões de passagens vetorizadas. Isso permite buscar por sobre o que o trecho fala, não apenas pelas palavras exatas que ele usa.
Na prática de operador, o desenho provável é este. Ingestão e limpeza das transcrições, quebra em janelas de contexto com sobreposição para não cortar frases no meio, geração de embeddings em lote na GPU local, indexação em banco vetorial e busca semântica por intenção histórica. Uma única consulta podia retornar dezenas de milhares de candidatos, volume impossível e caro de mandar para um modelo grande. Então entrou uma cadeia de modelos para afunilar. Um modelo menor e barato faz a triagem inicial, um modelo intermediário reordena e resume com citações, e só os finalistas vão para o modelo forte, que precisa extrair data, local, nomes, navio e justificar com trecho literal.
O pipeline enxuto que fez isso rodar em casa
- Triagem vetorial: busca por significado para vencer erro de OCR e variação ortográfica do holandês antigo.
- Filtros em cascata: modelos menores derrubam falsos positivos antes de gastar tokens caros no modelo maior.
- Prova física: todo candidato precisa apontar para a página escaneada original, não só para a transcrição.
Sobre custo e latência, não há número oficial publicado, mas dá para inferir sem delírio. Vetorizar 5,7 milhões de passagens em 12 horas cabe em uma GPU entusiasta recente, com throughput alto e custo elétrico baixo. O gasto real estaria na reranking com LLM, porque dezenas de milhares de chamadas quebram qualquer orçamento. A cascata resolve isso ao cortar 95 por cento ou mais antes da etapa cara. A latência total vira uma noite de processamento batch, não uma demo em tempo real, o que é aceitável para pesquisa histórica e péssimo para produto interativo.
O que isso muda na prática
Quem ganha primeiro não é o museu grande, é o pesquisador independente e o time pequeno com repertório técnico. Um engenheiro com bom domínio de agentes, banco vetorial e avaliação consegue produzir candidatos que antes exigiriam anos de bolsa e acesso físico ao arquivo. Arquivos nacionais, bibliotecas e projetos como o GLOBALISE também ganham, porque cada transcrição vira base consultável e cada achado verificado aumenta o valor do acervo. Quem perde, por enquanto, é o fluxo manual baseado em ler caixa por caixa e em índice de palavras exatas.
Se você constrói com IA, a ação prática é copiar o princípio da prova física. Monte sua busca sobre documentos históricos, jurídicos, técnicos ou de suporte com a mesma exigência, toda resposta precisa citar o trecho e linkar para a página fonte. Comece por um corpus pequeno e mensurável, defina o que é um acerto, rode a cascata com modelo barato na frente e caro só no fim, e registre taxa de falso positivo por semana. Em arquivos com OCR ruim, normalize datas e topônimos antes de vetorizar e guarde o texto original intacto para auditoria. Sem esse cinto, o sistema alucina com confiança e você publica um fato novo que nunca existiu.
Tensão e reflexão
Aqui fica a dúvida real de operador. Isso escala ou só funciona porque o escopo era estreito e a verificação era humana no final. Busca semântica resolve o recall, ela acha o que a palavra-chave perderia, mas cria um problema novo de precisão. Milhares de trechos parecidos, nomes repetidos, datas copiadas de jornal para jornal. O gargalo sai da leitura e vai para a validação. Alguém ainda precisa abrir o scan, ler a caligrafia, checar contexto, comparar com literatura existente. Sem historiador no loop, o pipeline vira fábrica de curiosidades frágeis.
Tem também o custo invisível da confiança. Um relato de meteorito esquecido ou uma erupção não registrada parece pequeno, mas entra para bases científicas e muda cronologias. Se a cadeia errar uma data ou confundir dois navios com o mesmo nome, o erro se propaga. Por outro lado, o acerto tem valor desproporcional, porque adiciona um ponto de dado onde não havia nenhum. A pergunta não é se a IA lê mais rápido, isso ela faz. A pergunta é se conseguimos manter o padrão de prova quando o volume sobe de dezenas para milhares de candidatos por noite.
Conclusão
No fim, apontar IA para 400 anos de papel funcionou porque trocou leitura exaustiva por busca por significado e manteve a exigência de mostrar o documento original. Resta saber quem vai montar esse mesmo rigor fora da história, nos seus próprios arquivos esquecidos.
Comentários
0 comentáriosNenhum comentário ainda. Seja o primeiro a comentar.