
O problema que ninguém resolveu ainda
Medicamentos descobertos por IA ainda não entregaram um único produto aprovado pela FDA. Essa é a verdade incômoda que precisa abrir qualquer conversa sobre a Enveda. Temos modelos cada vez melhores para prever estruturas de proteínas, para gerar moléculas do zero e para vasculhar bibliotecas químicas gigantescas em horas, mas transformar isso em um remédio seguro, eficaz e aprovável continua sendo um processo lento, caro e cheio de falhas na fase clínica. É nesse buraco entre predição computacional e biologia real que a Enveda tenta se posicionar, com uma tese diferente da maioria das AI biotechs.
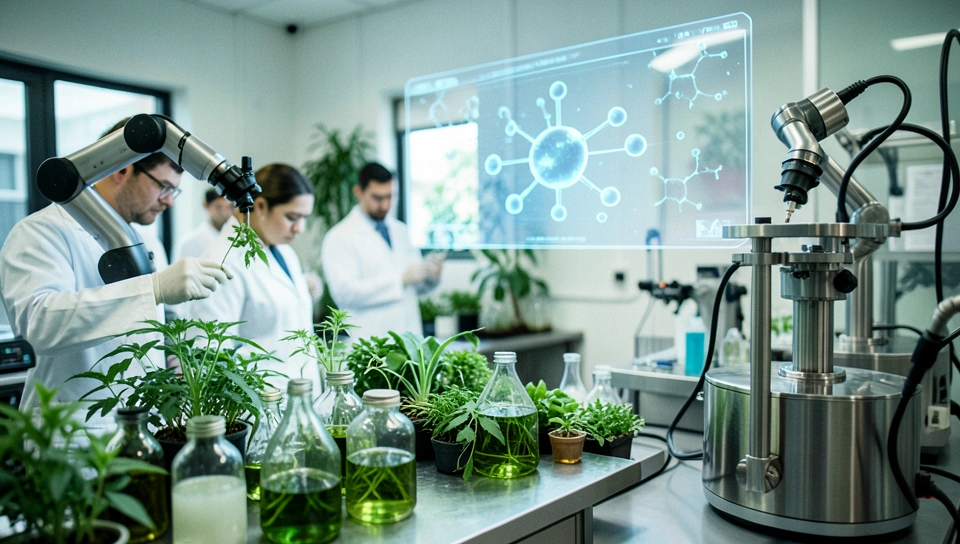
Ao invés de desenhar moléculas totalmente novas no computador, a empresa volta o olhar para algo antigo: plantas, micro-organismos e os metabólitos que a natureza já otimizou ao longo de milhões de anos de evolução. A ideia parece simples, quase óbvia, mas esconde uma complexidade brutal de dados. A natureza produz uma diversidade química absurda, a maior parte ainda sem caracterização, sem estrutura definida e sem relação clara entre composição e efeito terapêutico. Mapear esse espaço com velocidade é o trabalho sujo que a Enveda diz conseguir fazer com IA.
O fato
A Enveda levantou 311 milhões de dólares em uma Série E que avalia a empresa em 2 bilhões de dólares. A rodada foi liderada pela Catalio Capital Management, com participação da Iconiq e de outros investidores. Na prática, isso dobra o valuation da companhia em apenas 12 meses, um salto agressivo para um mercado de biotech que vinha mais cauteloso com teses puras de IA. Fundada em 2019 por Viswa Colluru, ex-funcionário inicial da Recursion Pharmaceuticals, a startup quer usar esse caixa para empurrar mais candidatos derivados da natureza para dentro de testes clínicos em humanos.
Hoje a empresa já tem programas em testes com pacientes, incluindo um candidato para condições severas de pele e outro focado em um problema muito atual: ajudar a manter a perda de peso depois da interrupção de GLP-1s. São duas apostas com lógica comercial clara. Dermatologia grave tem carência de terapias eficazes e toleráveis, enquanto o mercado pós GLP-1 pode virar uma das maiores fronteiras da farmacêutica nos próximos cinco anos. O recado para o mercado é direto: não estamos mais falando de plataforma futura, estamos falando de pipeline clínico.
Como funciona na visão de quem opera
Pensando como operador, a Enveda não é exatamente uma empresa de modelo generativo. Ela é muito mais uma empresa de dados massivos e de integração entre química analítica e machine learning. O fluxo provável combina coleta de amostras naturais, fracionamento, espectrometria de massa de alta resolução, ressonância magnética e ensaios fenotípicos, tudo amarrado por modelos que tentam correlacionar assinatura química com atividade biológica. Em vez de uma API que cospe moléculas, imagine um pipeline onde cada amostra vira terabytes de espectros e o modelo precisa aprender a dizer o que é ruído, o que é molécula conhecida e o que pode ser um scaffold novo com potencial terapêutico.
O custo aqui não está em inferência de LLM, está em geração e curadoria de dados proprietários. Espectrômetros, automação de laboratório, manutenção de biobanco e validação experimental custam muito mais do que GPU na nuvem. A latência também não se mede em milissegundos, e sim em ciclos de aprendizado de semanas ou meses entre prever, isolar, testar e voltar para o modelo. É um loop fechado de dry lab com wet lab, e a vantagem competitiva mora na qualidade desse loop, não em ter o transformer mais esperto. Quem já operou plataforma parecida sabe que o gargalo quase nunca é o algoritmo, é a reprodutibilidade do dado de entrada.
É plausível inferir que a Enveda use uma combinação de modelos de representação química, redes para predição de espectros e modelos de linguagem química treinados em produtos naturais, além de sistemas de desreplicação para evitar redescobrir o que a literatura já conhece. Nada disso é mágico, mas quando funciona bem, reduz drasticamente o tempo para ir de extrato bruto a candidato caracterizado. O desafio real começa depois: otimizar farmacocinética, toxicidade e manufatura de uma molécula natural complexa, que muitas vezes é difícil de sintetizar em escala. IA ajuda a priorizar, mas não elimina a química medicinal pesada que vem a seguir.
O que isso muda na prática
Para quem constrói em biotech e healthtech, o recado é que o dinheiro grande voltou a premiar quem tem dado proprietário e sinal clínico, não só deck de plataforma. Uma Série E de 311 milhões com valuation de 2 bilhões mostra que investidores top estão dispostos a pagar por redução de risco translacional. Quem ganha agora são equipes com capacidade de gerar dados experimentais de alta qualidade e levar ativos para fase 1 e 2. Quem perde são startups de descoberta puramente in silico, sem validação úmida, que vão ter cada vez mais dificuldade para justificar valuation sem um candidato em humanos.
- Mapeie produtos naturais ou bibliotecas subexploradas no seu domínio e cruze com dados fenotípicos reais antes de investir em modelo próprio.
- Se você opera com IA para saúde, priorize um loop curto entre predição e validação experimental, mesmo que pequeno, em vez de escalar modelo no vazio.
- Acompanhe o programa pós GLP-1 da Enveda como benchmark de desenho de trial para manutenção de peso, porque esse desenho vai virar padrão de mercado.
A ação prática mais imediata para fundadores e operadores é repensar custo por decisão válida. Não meça seu pipeline por quantas moléculas seu modelo gera por dia, meça por quantas hipóteses você consegue invalidar por semana com dado experimental confiável. A Enveda só consegue sustentar esse valuation porque trocou a métrica de vaidade de IA pela métrica que importa em farma: progressão clínica. Se você está construindo algo em AI for bio, replique isso no seu roadmap e deixe explícito para investidores onde seu loop wet e dry se encontram.
A tensão que fica
Aqui entra a dúvida real: isso escala ou só move o gargalo de lugar. Descobrir hits na natureza com IA é uma parte do problema. A outra parte, muito mais cara, é transformar um produto natural promissor em um fármaco manufaturável, patenteável e seguro para uso crônico. Moléculas naturais costumam ter estereoisomeria complexa, síntese difícil e perfil de propriedade intelectual mais frágil. A Enveda pode acelerar a descoberta em 10 vezes e ainda assim travar na otimização, na toxicologia ou na produção em escala. O capital ajuda, 311 milhões dão fôlego para errar e aprender, mas não compram biologia favorável.
Também existe a questão do custo de capital versus retorno. Valuation de 2 bilhões antes de qualquer aprovação exige um blockbuster ou uma plataforma capaz de gerar vários ativos licenciáveis para big pharmas. O programa de pele grave precisa mostrar eficácia diferenciada contra padrões já estabelecidos, e o programa pós GLP-1 vai competir com gigantes que dominam metabolismo e têm máquina comercial pronta. A tecnologia pode estar certa e o timing comercial ainda assim ser brutal. No fim, a pergunta que importa não é se IA encontra moléculas interessantes na natureza, porque encontra, e sim se encontra moléculas desenvolviveis mais rápido e mais barato do que a química tradicional já faz.
Conclusão
A Enveda tem caixa, tese diferenciada e candidatos em clínica, o que a coloca um passo à frente de muito hype de AI drug discovery. Resta saber se essa vantagem de descoberta vira aprovação e receita recorrente. Você pagaria hoje pelo risco clínico de produtos naturais guiados por IA ou esperaria a leitura dos dados de fase 2.
Comentários
0 comentáriosNenhum comentário ainda. Seja o primeiro a comentar.