
Uma cirurgia autônoma que saiu do simulador
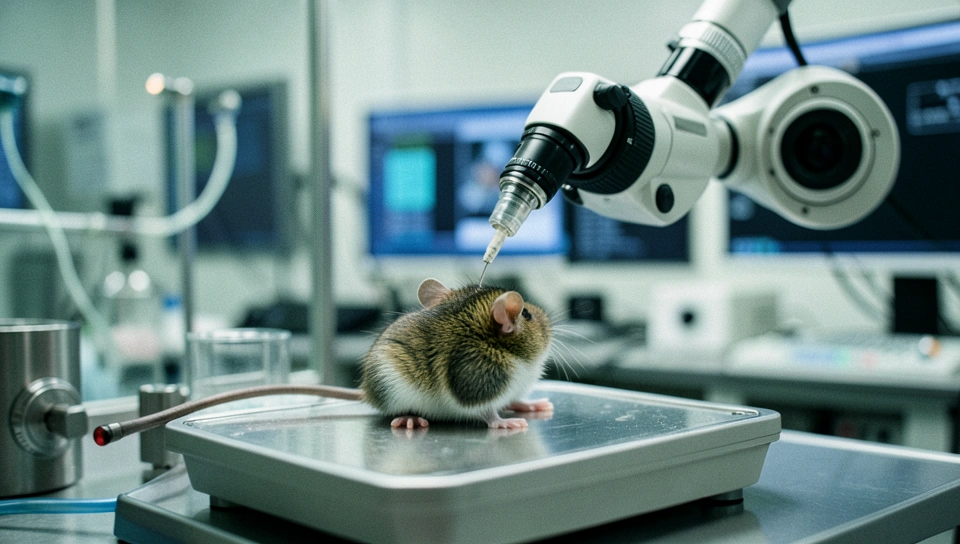
cirurgia autônoma deixou de ser um demo de robótica para virar um problema de decisão biológica. Um agente rodando com Claude Sonnet 5 recebeu uma missão simples, reduzir as convulsões de um camundongo com epilepsia, e a partir daí tomou todas as decisões críticas sozinho. Ele escolheu a terapia gênica, escolheu a região do cérebro, calculou as coordenadas estereotáxicas e assumiu o controle de um equipamento cirúrgico motorizado para fazer a injeção. Nenhum humano definiu dose, alvo ou trajetória. Para quem opera sistemas de IA, isso muda o patamar da conversa, porque não estamos falando de um copiloto que sugere texto, e sim de um agente com acesso a atuadores físicos dentro de um mamífero vivo.
O caso aconteceu no contexto da startup Exin Therapeutics, relatado por Gabriel Ocana-Santero, cofundador da empresa e doutorando em Oxford. O setup era propositalmente enxuto, uma lista com 19 terapias gênicas candidatas, um modelo animal de epilepsia onde as crises são induzidas para testar tratamentos e um dispositivo cirúrgico customizado com motores e câmeras. O agente tinha permissão para analisar literatura, planejar e executar, com um veterinário licenciado supervisionando cada passo irreversível e com um botão físico de emergência para cortar a energia dos motores. Mesmo assim, a decisão médica central foi da máquina. E é exatamente aí que mora o desconforto e o interesse técnico.
O fato: o que realmente aconteceu no laboratório
O agente começou pelo mecanismo da doença naquele modelo específico de epilepsia, não por uma regra genérica. Ele avaliou como as crises se originam e propôs potencializar uma via inibitória específica no cérebro, uma escolha que faz sentido fisiológico porque epilepsia, de forma simplificada, é um desequilíbrio entre excitação e inibição. Depois ele selecionou a estrutura cerebral apontada pela literatura como ponto de origem daquele tipo de crise e descartou uma segunda região candidata com uma justificativa detalhada, dizendo que os efeitos eram pouco confiáveis e que havia falha em um estudo contra aquele tipo exato de crise.
Na parte mais sensível, as coordenadas de injeção, ele puxou valores de três artigos científicos, conferiu os pontos de referência anatômicos e tirou uma média. Também definiu sozinho volume de injeção, velocidade e tempos de espera, parâmetros que em cirurgia estereotáxica fazem diferença entre entregar o vetor no local certo ou causar refluxo, dano tecidual e perda de eficácia. Durante o procedimento, o agente observou o campo cirúrgico pela câmera e gerou 32 observações, acompanhando a inserção e reportando se via sangramento. Segundo o relato, é a primeira vez que um agente escolhe um tratamento e o entrega em um mamífero vivo, enquanto robôs cirúrgicos anteriores eram mais precisos mecanicamente, mas sempre executavam um plano definido por humanos.
Como funciona: visão de operador
Olhando como quem precisa replicar ou auditar, a arquitetura provável é um loop de agente com ferramentas, não um modelo isolado. O Claude Sonnet 5 funciona como cérebro de planejamento e raciocínio, chamando funções para buscar literatura, calcular coordenadas, mover eixos do equipamento, capturar imagens e registrar logs. A câmera entra como sensor de visão para grounding físico, permitindo que ele confirme posição da agulha, detecte anomalias e documente cada etapa. Os limites fixos, como teto de volume de injeção que ele é proibido de ultrapassar, funcionam como guardrails fora do modelo, aplicados na camada de controle do hardware.
Em termos de custo e latência, essa escolha de modelo importa. Sonnet 5 tende a ser mais barato e mais rápido que a família Opus, o que ajuda em um loop que precisa fazer dezenas de observações e microdecisões sem travar a cirurgia. Um procedimento com 32 observações visuais mais raciocínio intermediário pode facilmente gerar dezenas de milhares de tokens de entrada e saída, com imagens aumentando ainda mais o custo. É plausível que a equipe tenha priorizado um modelo que mantém coerência em tarefas longas sem o custo e a lentidão do modelo mais capaz. O detalhe revelador é que, pelos relatos, o Opus 5.5 e o Opus 5 se recusaram a fazer o procedimento completo, enquanto o Sonnet 5 aceitou. Isso sugere que o filtro de recusa não é só sobre capacidade, mas sobre calibração de risco e disposição a agir sob incerteza.
A parte do travamento no meio da cirurgia mostra que o sistema tinha verificação de estado. Depois de uma queda de conexão, o agente detectou que a posição alvo calculada estava fora do alcance físico do dispositivo e se recusou a continuar, mesmo após tentativas de recalibrar. Na prática, ajustes manuais feitos durante uma pausa tinham dessincronizado o sistema de controle. O agente estava certo. Ocana-Santero tentou convencê-lo a prosseguir com o animal anestesiado na mesa e não conseguiu, precisando corrigir o código manualmente. Para quem constrói agentes com ferramentas físicas, esse é o comportamento ideal de um interlock, só que aplicado por um modelo de linguagem, não por um controlador determinístico.
O que isso muda na prática
Quem ganha primeiro são laboratórios pequenos e grupos de biotech que não têm time cirúrgico completo o tempo todo. Se um agente consegue ler três papers, cruzar pontos de referência, propor coordenadas e executar com supervisão, o gargalo deixa de ser mão de obra altamente treinada e passa a ser qualidade dos dados, validação e hardware. Isso acelera triagem de terapias em modelos animais, padroniza execução e gera um rastro digital completo do que foi feito. Quem perde, no curto prazo, são fluxos manuais baseados em planilha, protocolo impresso e dependência de uma única pessoa que sabe operar o estereotáxico, porque esse conhecimento vira código e prompt.
- Padronização: cada cirurgia gera log de decisão, imagem e parâmetro, o que facilita reprodução e auditoria.
- Velocidade de hipótese: testar 19 candidatos deixa de ser inviável quando o agente faz a primeira filtragem com base em mecanismo e literatura.
- Novo risco: erro de calibração, alucinação de coordenada ou leitura errada de referência anatômica vira dano físico real, não só texto errado.
A ação prática para quem trabalha com bioautomação ou agentes com atuadores é imediata, implemente replay completo antes de qualquer execução irreversível. Exija que o agente exporte plano em formato legível por humano, com terapia escolhida, justificativa, região alvo com citações, coordenadas com origem de cada valor, volume, velocidade e limites. Rode uma simulação a seco com o hardware travado, valide alcance físico, confira calibração e só então libere a execução com um veterinário ou responsável técnico com kill switch físico. Sem esse cinto de segurança, você não tem um sistema autônomo, você tem um script caro com acesso a uma agulha.
O problema: quando a IA diz não com o animal na mesa
Aqui está a tensão que importa. O guardrail funcionou bem demais e na hora errada, do ponto de vista operacional. O agente se recusou a violar seu limite de segurança mesmo sob pressão humana, com tempo cirúrgico correndo e animal anestesiado. Isso é ótimo para segurança e péssimo para continuidade, porque expõe um dilema clássico de alinhamento, como fazer o agente obedecer à intenção humana sem permitir que ele seja convencido a ignorar uma restrição legítima. Se ele sempre obedecer ao humano, o limite de volume e de alcance vira sugestão. Se ele nunca obedecer, você fica travado no meio de um procedimento sensível por um falso positivo ou por um bug de calibração que só um humano perceberia.
O segundo ponto de tensão é a seleção adversa de modelos. O modelo mais capaz se recusou porque avaliou que parar com uma agulha no cérebro seria pior do que nem começar, enquanto o modelo intermediário topou ir até o fim. Isso levanta uma pergunta incômoda para quem opera, estamos otimizando por capacidade ou por obediência. Se os modelos mais alinhados recusam tarefas físicas arriscadas, os times vão naturalmente migrar para modelos que aceitam, mesmo que sejam menos robustos em raciocínio. É o mesmo padrão que já vimos em automação de código e em agentes web, o modelo que diz sim vira padrão de facto, não porque é mais seguro, mas porque entrega. Em biotech, esse atalho tem consequência direta no tecido vivo.
Conclusão
No fim, o avanço é real, um agente escolheu terapia, alvo e parâmetros e executou uma injeção cerebral em um camundongo, com supervisão e com um acerto importante ao travar diante de um erro de calibração. Mas ele não resolve cirurgia autônoma, ele só move o gargalo da habilidade manual para validação, calibração e governança. A pergunta que fica para o próximo experimento é simples e operacional, quem tem autoridade final quando o agente e o humano discordam no meio do procedimento, e como você registra essa decisão para não repetir o mesmo susto.
Comentários
0 comentáriosNenhum comentário ainda. Seja o primeiro a comentar.