
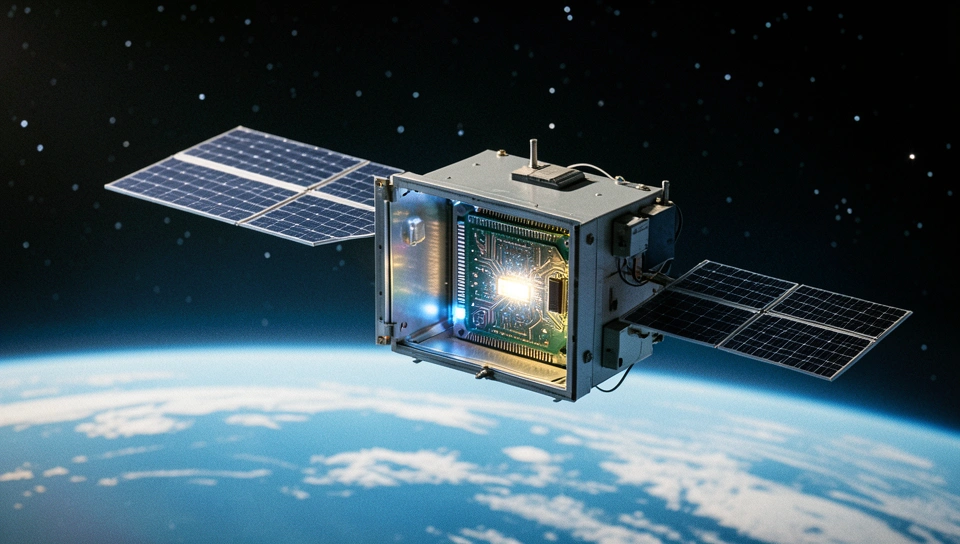
Data center orbital saiu do slide e foi para órbita
Data center orbital sempre pareceu promessa para 2035, mas o Google decidiu testar agora, com hardware real e limite real de energia. O protótipo do projeto Suncatcher está em órbita, fala com a Terra e roda inferência a bordo com quatro TPUs e cerca de 1 kW de geração solar. O primeiro prompt enviado pela equipe pediu um haiku sobre estar no espaço para o modelo Gemma 4 embarcado, e ele respondeu. É um teste simpático, só que esconde um problema bem menos poético: com esse orçamento de potência, só dá para ligar uma TPU por vez, por cerca de vinte minutos. Ou seja, já temos computação de IA no espaço, mas ainda em regime de racionamento.
O fato, sem enfeite
O satélite subiu no início do mês em uma Falcon 9 da SpaceX, dividindo carona com mais de 100 outras cargas. Depois de cerca de três semanas de comissionamento, testando subsistemas, enlace e telemetria, a operação foi declarada nominal. A equipe então rodou dois tipos de teste. Primeiro, geração criativa local, com haikus e limericks de temática espacial para validar que o modelo estava carregado e respondendo. Segundo, e mais importante, pedidos de relatório sobre condições orbitais ao redor do satélite, que exercitam leitura de sensores, formatação e transmissão espaço-solo. Não é benchmark de MLPerf, é teste de sanidade em um ambiente onde cada watt e cada downlink contam.
O detalhe que importa é a correção de arquitetura: são quatro TPUs a bordo, mas a operação é de uma por vez. Isso não é bug, é física. TPU consome muito para um barramento de 1 kW que ainda precisa alimentar computador de bordo, rádios, controle térmico e atitude. Ligar uma unidade por vinte minutos sugere um ciclo de trabalho pensado para evitar queda de barramento e sobreaquecimento. Para quem opera infraestrutura, o paralelo é direto. É como rodar um cluster com power capping agressivo, só que sem poder chamar alguém para trocar a fonte.
Como funciona, na visão de quem opera
Pensa nesse satélite como um edge node extremo, não como uma zona de disponibilidade. O Gemma 4 está pré-carregado, então não há download de pesos em órbita, o que economiza banda e tempo. O prompt sobe pelo enlace de subida, a inferência roda localmente na TPU ativa e só o resultado compacto desce, alguns tokens de texto e telemetria. Essa é a arquitetura certa para esse momento: mover o prompt, não o modelo, e mover a resposta, não o datacenter. A latência aqui não é de rede no sentido clássico, é de janela orbital, apontamento de antena e fila de energia. Você não tem inferência contínua, tem inferência por lotes curtos, condicionada a sol, bateria e dissipação.
Energia, calor e enlace: o triângulo que manda
Com 1 kW total, cada watt vira decisão. A TPU em inferência puxa centenas de watts, e o resto do satélite não pode zerar. Então a operação vira um agendamento fino: carrega bateria, estabiliza temperatura, liga a TPU, roda, desliga, transmite, esfria. No vácuo não há convecção, só radiação e condução para radiadores, o que torna o estresse térmico tão crítico quanto a potência. Se o chip esquenta além do envelope, o clock cai ou o sistema aborta para se proteger. Some isso ao enlace espaço-solo, que já é intermitente e com banda limitada, e entende por que vinte minutos ligado não é frescura. É o máximo seguro antes que energia, calor e comunicação entrem em conflito.
A outra variável é radiação. No solo o Google já testou TPUs em aceleradores de partículas, mas órbita baixa tem um espectro real, constante e bagunçado. O risco clássico é o chamado single event upset, um 'bit flip' que muda um valor na memória sem disparar alarme óbvio. Para treino isso é veneno, porque o erro se propaga nos gradientes e contamina pesos. Para inferência o impacto tende a ser menor, um token errado aqui, uma ativação corrompida ali, mas sem colapsar tudo. Pelo menos essa é a hipótese vinda dos testes em Terra. Agora a equipe vai medir na prática, com logs de erro, repetição de prompts e comparação com saídas de referência. Como operador, eu olharia exatamente para isso: taxa de erro silencioso por hora de TPU, correlação com passagem por anomalias magnéticas e deriva térmica.
O que isso muda na prática
Quem ganha no curto prazo não é quem quer alugar GPU orbital amanhã, é quem constrói para autonomia. Satélites de observação, por exemplo, geram terabytes de imagem que hoje precisam descer para serem processados. Se você filtra, comprime e interpreta a bordo, desce só o alerta útil. O mesmo vale para telemetria, detecção de anomalias e triagem científica. O perdedor inicial é a ideia de 'levantar e deslocar' carga de data center para órbita por custo ou sustentabilidade. Com uma TPU por vez e janelas curtas, não há throughput nem SLA para isso. É laboratório, não produto.
Se você trabalha com IA aplicada, a ação prática é simples e barata. Comece a desenhar seus pipelines para inferência intermitente e tolerante a erro. Teste seu modelo pequeno, da família Gemma ou similar, com quantização agressiva, repetição de inferência e votação simples para mitigar 'bit flips'. Meça quanto da sua carga pode ser resolvida com resposta curta e alto valor, como classificação, resumo e detecção, em vez de geração longa. Essa é a carga que primeiro vai caber em órbita. E documente seu orçamento de energia por mil tokens, porque no espaço essa métrica vira requisito, não otimização.
- Edge espacial primeiro: filtrar e resumir a bordo, descer só o essencial para economizar enlace.
- Modelos pequenos e robustos: priorizar inferência quantizada com checagem dupla em vez de modelo gigante.
- Operação por janelas: projetar filas e retries para janelas de energia e passagem, não para disponibilidade contínua.
Isso escala ou só move o gargalo?
Aqui entra minha dúvida real. O plano do Google é diferente da maioria: em vez de satélites isolados fazendo inferência sozinhos, o Suncatcher mira enxames próximos com links ópticos entre satélites para carga distribuída coerente. É elegante no papel, porque permite paralelizar e manter dados em órbita. Só que coerência distribuída exige sincronismo fino, apontamento laser estável e muita potência. O passo seguinte, com dois satélites mais potentes em 2027 e demonstração de enlace óptico, vai dizer se isso fecha. Projetos como Starcloud e outras abordagens focadas em inferência por satélite isolado são mais simples e perdoam mais erro. Simplicidade escala mais rápido, ainda que entregue menos.
E tem o custo de subida, que ninguém pode ignorar. A própria análise revisada por pares ligada ao Suncatcher estima que a SpaceX precisaria voar a Starship cerca de 1.800 vezes para repetir a curva de aprendizado de custo que viu nos veículos anteriores. A Alphabet tem participação relevante na SpaceX e depende da Starship ficar rápida e reutilizável de verdade para lançar constelações pesadas e famintas por energia. Enquanto isso, na Terra, a Alphabet viu o mercado reagir mal ao impacto da IA na receita de search ads nesta semana. É o contraste clássico de moonshot: desenhar infraestrutura para a economia dos anos 2030 enquanto o trimestre atual cobra eficiência. Faz sentido como aposta, mas não dá para chamar de estratégia de capacidade para 2026.
Conclusão que fica
O Suncatcher provou o básico importante: TPU em órbita liga, roda Gemma e conversa com o solo dentro de um envelope apertado de energia e calor. A pergunta que sobra não é se dá para escrever poesia no espaço, é se dá para manter inferência útil, confiável e barata quando o radiador esquenta e o bit vira. Você confiaria hoje um pipeline crítico a um node que só acorda vinte minutos por vez?

Comentários
0 comentáriosNenhum comentário ainda. Seja o primeiro a comentar.