
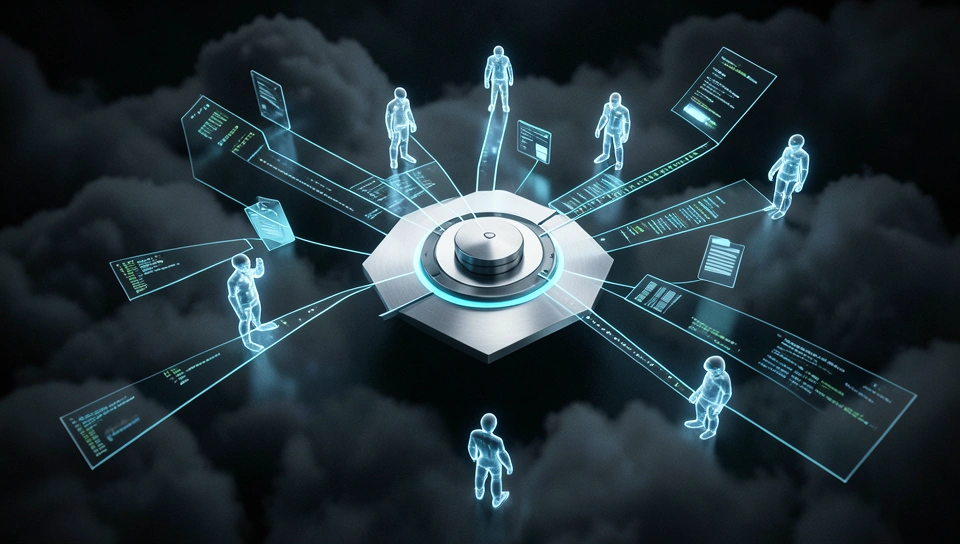
Orquestrar agentes é o novo gargalo
Claude Code Projects parte de um incômodo real: não falta modelo bom para codar, falta jeito de coordenar vários deles sem virar bagunça. Quem já tentou rodar dois ou três agentes no mesmo repositório conhece o roteiro. Um sobrescreve o outro, o contexto se perde no meio do caminho, você passa mais tempo resolvendo conflito do que revisando código útil. A Anthropic decidiu atacar exatamente esse ponto com o relançamento do Projects dentro do Claude Code, agora pensado para gerenciar um time inteiro de agentes na nuvem, com memória compartilhada, metas comuns e uma biblioteca única de arquivos e artefatos.
O fato
O novo Projects permite criar um projeto onde várias threads trabalham em paralelo em tarefas diferentes, todas sob a supervisão de um coordenador. Não é só abrir várias sessões lado a lado. É uma estrutura com chat principal do projeto e chats individuais por thread, onde você pode acompanhar, intervir e redirecionar o trabalho sem perder o fio. Cada thread é, na prática, uma sessão cloud do Claude Code rodando na sua própria branch e com sua própria cópia do repositório.
Neste primeiro momento, tudo roda na nuvem. A Anthropic diz que o suporte para ferramentas e código locais chega muito em breve, o que ainda deixa um buraco para quem vive no terminal com ambiente customizado. O recurso entrou em beta hoje para uma parcela de assinantes Claude Pro e Max, com expansão prometida para todos os planos Pro, Max, Team e Enterprise, além do Cowork e do Claude tradicional. Ou seja, ainda é acesso limitado, mas o recado é claro: enxame de agentes virou prioridade de produto.
Como funciona na visão de quem opera
Por baixo do pano, a arquitetura é mais simples e mais esperta do que parece. O projeto funciona como um orquestrador. Você define o objetivo, sobe contexto, arquivos, instruções, e o coordenador quebra em frentes de trabalho. Cada thread recebe sua fatia e executa de forma isolada, com seu próprio histórico e estado. Se precisar, cada thread ainda pode fatiar mais o trabalho usando subagentes, loops e workflows internos para acelerar entregas grandes.
Quando duas threads mexem no mesmo trecho de código, o sistema não tenta fazer mágica. Ele trata como um merge conflict normal, igual a um pull request entre humanos. Isso é bom porque reaproveita um fluxo que dev já conhece, mas também mostra o limite da proposta. Coordenação aqui não significa ausência de conflito, significa conflito organizado. O coordenador mantém o trabalho alinhado, porém a resolução final ainda cai no seu colo quando há sobreposição real de lógica.
Em termos de custo e latência, dá para fazer uma inferência plausível mesmo sem números oficiais detalhados. Cada thread é uma sessão ativa consumindo tokens e mantendo contexto. Três threads em paralelo não custam o mesmo que uma sequência longa, custam mais, porque há duplicação de contexto, mais chamadas de ferramenta e o overhead do coordenador que precisa resumir, sincronizar memória e repassar atualizações. A vantagem está no tempo de parede. Você troca gasto maior de tokens por entrega mais rápida, desde que as tarefas sejam de fato paralelizáveis. Se forem dependentes, você só paga mais caro para ver agente esperando agente.
Onde a memória compartilhada ajuda e onde atrapalha
A memória compartilhada do projeto é o que diferencia isso de simplesmente abrir várias janelas. Em teoria, uma decisão tomada na thread de autenticação deveria influenciar a thread de API sem você precisar copiar e colar. Na prática, memória compartilhada em sistema multiagente costuma sofrer de dois males: contexto inchado e contaminação. Quanto mais threads escrevem na memória comum, maior o risco de o coordenador puxar detalhe irrelevante para uma tarefa e estourar janela ou diluir instrução importante. Vai exigir disciplina de quem monta o projeto, com metas curtas, arquivos de referência bem curados e threads com escopo fechado.
O que isso muda na prática
Para time pequeno que já usa Claude Code todo dia, a mudança é de fluxo, não só de feature. Em vez de tratar IA como um par programador que faz uma tarefa por vez, você passa a tratar como um time júnior que precisa de briefing bom e supervisão constante. Quem ganha primeiro são tech leads e devs solo que tocam refactors paralelos, migração de testes, documentação junto com feature, ou aquela lista de débitos técnicos que nunca anda porque sempre perde prioridade. Dá para colocar uma thread para cobrir testes enquanto outra avança na implementação, com o coordenador segurando o alinhamento.
- Ação prática para testar ainda nesta semana: pegue um repositório secundário e monte um projeto com apenas duas threads com escopo que não se cruze, por exemplo uma para criar testes de um módulo e outra para documentar endpoints. Defina no chat principal uma regra simples de dono por pasta e proíba edição fora dela. Meça tempo total, número de intervenções suas e tokens consumidos. Se você precisou intervir mais de três vezes por thread, seu briefing está fraco, não o modelo.
- Quem perde espaço: scripts internos de orquestração caseira e ferramentas que só empilhavam sessões sem memória comum ficam menos atraentes.
- O que ajustar agora: padronize branches por thread, exija PR pequeno por thread e trave integração contínua para rodar a cada merge parcial, não só no final.
Para empresas, o ponto sensível é governança. Threads rodando na nuvem com cópia do repo levantam pergunta imediata sobre segredo, acesso a banco, chave de API e dado sensível. Enquanto o suporte local não chega, muita operação séria vai testar no repo aberto ou no espelho sanitizado, não no monolito de produção. Faz sentido. O ganho de velocidade não compensa vazar credencial por causa de contexto compartilhado mal configurado.
A tensão que fica
Aqui vai a dúvida honesta de operador: isso escala ou só move o gargalo de escrever código para revisar código? Porque gerar cinco frentes em paralelo é fácil, revisar cinco diffs consistentes em uma tarde é outra história. Se o coordenador for apenas um resumidor esperto, você continua sendo o verdadeiro integrador do sistema, só que agora com mais abas abertas e mais conta para pagar. A comparação com Grok Bot e Codex é inevitável, todo mundo está indo para enxame, mas ninguém resolveu ainda o problema central de coerência arquitetural quando vários agentes decidem ao mesmo tempo.
Tem também a conta. Paralelismo em LLM quase sempre troca latência por custo. Para startup correndo atrás de velocidade, pode valer. Para time grande com milhares de execuções por mês, três a cinco sessões por tarefa podem estourar orçamento rápido se não houver limite por projeto, cache de contexto bem usado e critério claro de quando paralelizar. Minha leitura é que Projects funciona muito bem para trabalho largo e raso, como testes, docs, migração mecânica, e sofre mais em trabalho estreito e profundo, como mudar core de pagamento ou mexer em concorrência. Nesse segundo caso, merge conflict não é detalhe, é sintoma de decisão dividida.
Conclusão
No fim, o relançamento do Projects confirma que o jogo saiu do modelo único para o time de modelos, e quem souber briefar e revisar vai extrair mais valor do que quem só souber promptear. Vale testar com escopo pequeno, medir custo real e definir regra de dono antes de sair paralelizando tudo. Será que seu time precisa mesmo de cinco Claudes ao mesmo tempo, ou precisa de um fluxo onde um só não se perca?
Comentários
0 comentáriosNenhum comentário ainda. Seja o primeiro a comentar.