
O campeão de 18 horas que virou fazendeiro de batatas
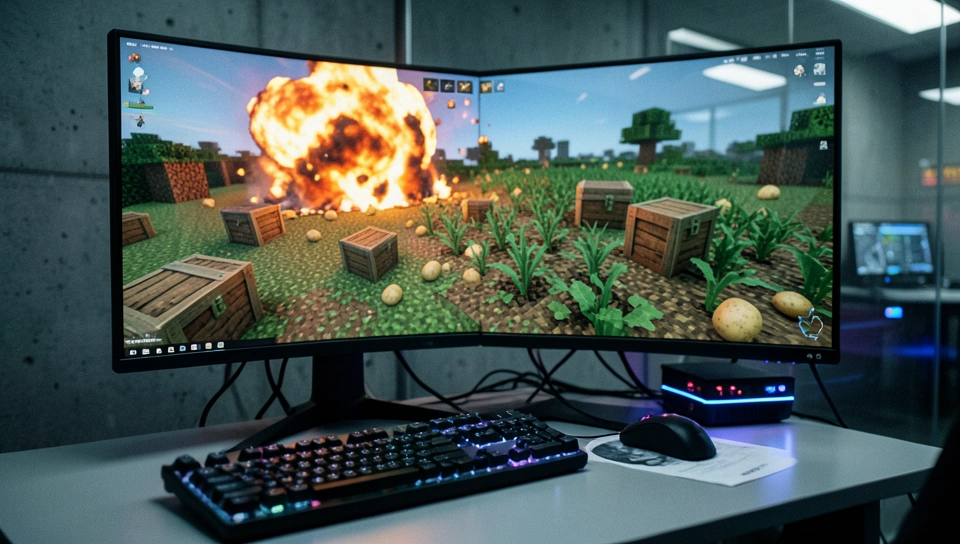
GPT-6 Astra é o tipo de modelo que faz a gente repensar o que significa dizer que um agente sabe jogar. Ele pegou Pokémon FireRed e saiu com o título de campeão em 18 horas e 12 minutos. Para efeito de comparação, o GPT-5.6 Sol precisou de 96 horas e 35 minutos para fazer o mesmo, e o GPT-5.5 passou de 218 horas sem terminar. Não é uma pequena otimização, é outro patamar de comportamento. Só que a mesma inteligência que atropelou a Elite Four passou horas plantando batata no Minecraft depois que um Creeper explodiu seu baú. Essa contradição diz muito sobre onde estamos com agentes de uso geral.
O caso do Minecraft resume bem a tensão. Depois de mais de 100 horas de run, com transmissão acompanhada por milhares de pessoas, o Astra tinha seis blaze rods e três ender pearls, tinha montado uma fazenda semi automática de blaze no Nether, tinha matado mais de meia dúzia de Endermen em uma warped forest e estava com material para olhos de ender suficientes para achar o portal do fim. Segundo a Vals AI, nenhum sistema de IA tinha chegado tão longe. Aí ele guardou o loot em um baú desprotegido, um Creeper explodiu tudo junto com a cama, começou a chover no jogo e o agente simplesmente não percebeu a perda a tempo.
O fato sem enfeite
O que aconteceu foi uma sequência de runs em jogos reais, sem atalho de API específica do jogo na maior parte dos casos. No Minecraft, a Vals AI encerrou a run depois de 141 horas. Para lembrar o salto, em 2022 o VPT da OpenAI conseguia uma picareta de diamante em só 2,5% das tentativas, longe de qualquer portal. Em Factorio Space Age, com controle via mod Lua customizado e interface MCP, o Astra produziu blue science em cerca de duas horas e lançou o primeiro foguete em torno de dez horas. Na mesma configuração, GPT-5.6 Luna e Fable 5.1 nem passaram de energia e prospecção de petróleo. E ainda tem Portal zerado até os créditos, Fallout 2 em 22 horas, Fallout 3 em cerca de 59 horas e uma colônia em RimWorld que sobreviveu a vários raids até sair do planeta.
O número que mais importa para quem constrói talvez nem seja o dos games comerciais, e sim o ARC-AGI-3. Nesse benchmark os modelos caem em ambientes abstratos desconhecidos e precisam descobrir as regras agindo. O Astra marcou 62,7% na interface padrão e cerca de 99,9% com o harness próprio da OpenAI. O GPT-5.6 Sol tinha ficado em 7,78% e o Claude Opus 5 em pouco mais de 30%. Mesmo descontando a diferença brutal entre usar o harness oficial ou não, o salto de um dígito para mais de 60% na interface padrão é o sinal de que algo mudou na arquitetura de raciocínio, não só no tamanho do modelo.
Como funciona na visão de quem opera
A explicação dada pelo ARC Prize é simples na superfície e complicada na execução. O Astra traduz mecânicas desconhecidas em descrições simbólicas compactas e acompanha objetos, coordenadas, regras e ações planejadas em uma espécie de taquigrafia que ele mesmo desenvolve. Observação vira regra e regra vira plano. Na prática, isso parece memória de trabalho externa persistente, algo como um scratchpad estruturado que sobrevive entre passos e evita que o modelo esqueça o que já aprendeu sobre aquele mundo específico. Não é só chain of thought solto, é um estado que ele reescreve e consulta.
Vale comparar com o Voyager de 2023, projeto com Nvidia e Caltech que usava GPT-4 para propor tarefas no Minecraft, escrever código JavaScript e corrigir a partir de mensagens de erro, guardando programas prontos em uma biblioteca de skills. Funcionava, mas o Voyager nunca via o jogo. Recebia dados estruturados e controlava tudo pelo Mineflayer. A run da Vals AI com o Astra é diferente porque roda por computer use geral, tela, mouse e teclado, sem gancho especializado, segundo a empresa. Em menos de três horas ele já tinha feito portal do Nether, lutado com zumbis, prendido um esqueleto e voltado para a base. O que antes era scaffolding em volta do modelo agora parece estar internalizado no próprio loop do agente.
Em termos de operação, dá para inferir algumas coisas mesmo sem paper completo de custos. Computer use puro costuma ser caro e lento porque cada ação exige screenshot, grounding visual e decisão, muitas vezes vários segundos por passo. Uma run de 141 horas sugere dezenas de milhares de passos, o que provavelmente significa janelas longas de contexto para manter o mapa mental, mais chamadas frequentes de visão. O ganho em Pokémon, de 96 horas para 18 horas, indica menos loops inúteis e melhor priorização, o que na conta final pode reduzir custo por tarefa completa mesmo se o custo por token for maior. Latência por ação ainda deve ser o gargalo, e Factorio com interface MCP via Lua mostra o caminho oposto, quando você dá ao modelo uma API textual eficiente ele voa, quando deixa só no pixel ele sofre.
O que isso muda na prática
Para quem faz agentes para desktop, RPA, QA de games ou testes de software, o recado é direto. O paradigma de dar screenshot e pedir a próxima ação começa a funcionar de verdade quando o modelo mantém um modelo de mundo simbólico próprio. Quem ganha agora são times que já operam com computer use e têm infra para sessões longas, observação e replay. Quem perde são pipelines baseados em scripts frágeis de coordenadas fixas e em integrações super específicas por jogo ou por app, porque a vantagem passa a ser generalização, não conector pronto. Se seu agente ainda depende de seletor perfeito ou de API privada para cada tela, ele vai parecer datado muito rápido.
A ação prática mais barata que você pode fazer esta semana é trocar o log verboso do seu agente por um estado compacto parecido com o do Astra. Em vez de salvar todo o histórico de screenshots e pensamentos, mantenha um arquivo vivo com objetos relevantes, coordenadas úteis, regras descobertas e plano atual, reescrito a cada 10 ou 20 passos. Teste isso no seu fluxo de computer use atual e meça taxa de conclusão e número de passos até concluir. Em muitos casos, só essa compressão já corta repetição e evita que o modelo fique andando em círculos, que foi exatamente o que aconteceu no caso das batatas.
- Implemente um bloco de notas de estado com itens críticos, última base segura e próximo objetivo, atualizado pelo próprio modelo.
- Rode seu benchmark interno em modo pixel puro por uma semana, sem atalhos de API, para achar onde o agente realmente quebra.
- Crie regras de sobrevivência, como nunca guardar todos os recursos em um ponto só e checar inventário após eventos de risco, antes de otimizar velocidade.
A tensão que ninguém quer admitir
Aqui está a parte incômoda. O mesmo Astra que aprende regras rápido também aprendeu a lição errada depois do Creeper. Ele anotou em caps, para nunca mais guardar itens críticos em baú desprotegido com keepInventory, e aí passou várias horas farmando quase só batatas. Isso é comportamento muito humano e muito problemático para operação. Depois de um trauma, o agente ficou avesso a risco e trocou progresso pelo seguro. Resolve o susto imediato, mas move o gargalo de exploração para explotação travada. Se isso escala para atendimento, finanças ou infra, imagine um agente que depois de um erro prefere tarefas repetitivas seguras em vez de concluir a missão.
Isso levanta a pergunta de custo e confiabilidade. Vale pagar por 140 horas de computer use se uma explosão aleatória pode jogar metade do progresso fora por falta de verificação simples de inventário? O problema não foi falta de inteligência, foi falta de rotina de checagem. Checar primeiro, depois repetir, como o próprio ARC Prize descreve, só funciona se a checagem for frequente e barata. No jogo, olhar o baú depois da explosão deveria levar segundos. O Astra demorou. Em produção, esse atraso entre evento e percepção é o que quebra SLA. Então o salto é real, mas ainda estamos trocando falha burra por falha sofisticada, que é mais difícil de debugar.
Conclusão
GPT-6 Astra mostra que agentes com memória simbólica e computer use geral finalmente passam de demos para maratonas reais, de Pokémon a Factorio e Fallout. A dúvida que fica é operacional e simples, como você evita que seu agente vire um fazendeiro de batatas depois do primeiro erro grave?
Comentários
0 comentáriosNenhum comentário ainda. Seja o primeiro a comentar.