
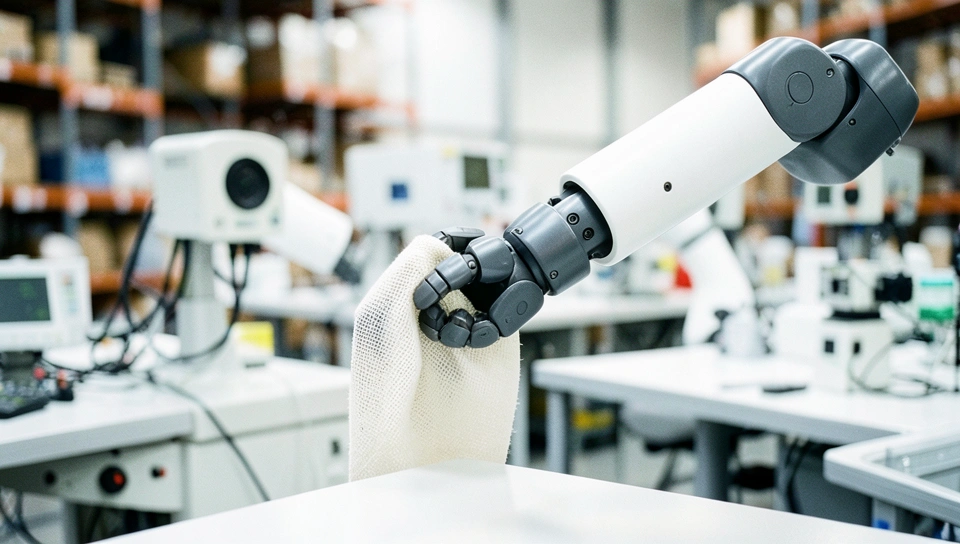
Colocar robô para trabalhar ainda é um inferno de integração
Pi API é a tentativa mais direta de resolver o gargalo que trava a robótica hoje: não falta hardware, falta cérebro adaptável. Quem já tentou colocar um braço robótico para dobrar uma peça de roupa do avesso, pegar um ingrediente que não para na colher ou lidar com uma peça que caiu torta na esteira sabe como é. O demo funciona no laboratório, mas quebra na terceira variação do mundo real. E aí começa o ritual doloroso: coletar mais demonstrações, ajustar modelo, montar pipeline de dados, alugar GPU, testar de novo no robô e descobrir um novo modo de falha.
A Physical Intelligence vive desse problema. Depois dos modelos π0 e π0.5, que já mostraram que um foundation model generalista pode reduzir muito o dado necessário para uma tarefa nova, a empresa agora quer tirar o peso da infra das costas do desenvolvedor. A ideia é simples de entender e difícil de executar: você sobe seus dados, roda fine-tuning em computação gerenciada por eles e consome o modelo ajustado por um gateway hospedado. Na teoria, qualquer robô ganha inteligência física sem precisar montar time de ML do zero.
O fato
O que aconteceu é objetivo. A Physical Intelligence lançou o beta da Pi API, liberando seus modelos mais recentes para treino e inferência através de API. O fluxo anunciado tem três etapas: upload de demonstrações, fine-tuning em infraestrutura própria da Pi e inferência via nuvem através de um gateway hospedado. A empresa diz que o modelo atual disponível na API já tem fine-tuning mais eficiente em dados e capacidade melhor que as versões anteriores usadas com parceiros, e que pretende atualizar os modelos por trás da API de forma rápida.
Para validar, a Pi trabalhou em colaborações fechadas e depois liberou acesso antecipado para um grupo pequeno de empresas. Os casos vão do Japão à Suíça e a vários deployments nos Estados Unidos, cobrindo tarefas e hardwares diferentes. A maioria desses pilotos rodou com inferência hospedada na nuvem, não local. A empresa também admite um ponto sensível: houve desafios de conectividade de rede em alguns ambientes. É um detalhe que parece lateral, mas para quem opera robô em chão de fábrica, ele é central.
Como funciona na visão de operador
Pense na Pi API como um MLOps terceirizado para robótica. Você não baixa pesos para rodar localmente, pelo menos não nesse desenho inicial. Você empacota trajetórias, imagens de câmeras, propriocepção, ações e sinais de sucesso ou falha, sobe para a plataforma e dispara um job de fine-tuning. A Pi cuida de versionamento de dados, orquestração de GPUs, escolha de hiperparâmetros e checkpointing. Depois, seu robô não roda o modelo no edge, ele faz chamadas para inferência remota e recebe de volta ações ou políticas de controle em frequência alta.
É aqui que mora a engenharia real. Um policy de manipulação precisa responder em dezenas de milissegundos para não ficar mole ou instável. Se a inferência está na nuvem, você adiciona latência de rede, jitter e risco de queda em cima de um loop que já é sensível. É plausível que a API use inferência com streaming, batch pequeno, cache de contexto visual e compressão de observação para segurar o tempo de resposta, além de fallback local simples quando a conexão cai. A Pi não detalhou custo por chamada, throughput ou SLA no anúncio, então trate isso como ponto de interrogação. Em operação, o que importa é medir p50 e p99 fim a fim no seu ambiente, não no benchmark deles.
O loop de iteração é o melhor ativo da proposta. O padrão que a Pi observou nos parceiros se repete em quase todo projeto de robótica: coletar demonstrações, treinar, testar no robô, analisar falhas e decidir qual dado coletar em seguida. A API tenta encurtar esse ciclo para horas em vez de semanas. Na prática, isso significa que o valor não está só no modelo base, está na velocidade com que você consegue errar, corrigir o dataset e subir uma nova versão sem gerenciar cluster. Para times pequenos, isso pode ser a diferença entre iterar cinco vezes por semana ou uma vez por mês.
O que isso muda na prática
Quem ganha primeiro são times que já têm robô e tarefa pagando a conta, mas não têm time de ML forte. Integradores, startups de automação para logística, cozinhas industriais, manufatura leve e até laboratórios. Eles podem testar uma hipótese de autonomia com 50 a 200 demonstrações bem curadas em vez de construir tudo do zero. Quem perde, no curto prazo, são fornecedores de stack fechada que vendiam projeto customizado a peso de ouro, porque parte do trabalho de percepção e controle passa a ser commodity via API.
Mas não se engane. Terceirizar o cérebro não elimina o trabalho sujo. Você ainda precisa de calça no chão: calibração de câmera, qualidade de teleoperação, consistência nas demos, cobertura de casos de borda e avaliação honesta no robô. Uma ação prática para começar agora: separe um conjunto de falhas reais filmadas e rode um piloto mínimo. Grave 30 minutos de demonstrações boas e 30 minutos focados só nos erros que você já viu, como objeto escorregando, oclusão ou posição errada. Suba em duas levas separadas e compare a taxa de sucesso antes e depois. Se o ganho não aparecer com dado de falha, o problema pode ser latência, hardware ou formulação da tarefa, não falta de dado.
- Meça latência real na sua rede antes de assumir autonomia via nuvem, com teste de 24 horas em horário de pico.
- Padronize coleta com checklist de iluminação, posição de câmera e velocidade de demonstração para evitar overfitting bobo.
- Defina critério de saída do piloto, como taxa de sucesso mínima e custo por hora operada, para não ficar preso em demo infinita.
A tensão que ninguém quer admitir
A dúvida real é se isso escala fora do ambiente controlado. Foundation model para robótica generaliza melhor que política treinada do zero, isso já está razoavelmente provado. Só que generalizar em vídeo é diferente de generalizar em contato físico, com atrito, peso e deformação variando. E quando você coloca inferência na nuvem, cria uma dependência nova: sua célula de manufatura ou seu robô de depósito passa a depender de internet estável, de preço por inferência e de roadmap de modelo de terceiros. Resolve o gargalo de ML e move o gargalo para rede, custo operacional e lock-in.
Tem ainda o lado econômico que a Pi não abriu. Quanto custa uma hora de robô chamando modelo de fronteira a 10 ou 20 Hz? Se a margem da sua operação é apertada, como em logística, esse custo recorrente pode matar a conta mesmo com taxa de sucesso boa. E se a Pi atualizar o modelo base por baixo da API, seu fine-tuning continua estável ou precisa de retreino? Quem opera sabe que mudança silenciosa de modelo é pesadelo de manutenção. A proposta faz sentido, mas o teste ácido não é o vídeo bonito de demonstração, é operação contínua por semanas, com troca de turno, sujeira no sensor e queda de rede.
Conclusão
A Pi API em beta transforma inteligência física em serviço utilizável: menos infra para gerenciar, iteração mais rápida e acesso a modelos que a maioria dos times jamais treinaria sozinha. O preço é depender da nuvem e provar economia na operação real. Vale testar com um caso estreito, medir latência e custo por tarefa e perguntar sem romance: isso opera todo dia ou só impressiona no piloto?
Comentários
0 comentáriosNenhum comentário ainda. Seja o primeiro a comentar.