
Factorio não perdoa agente enrolado
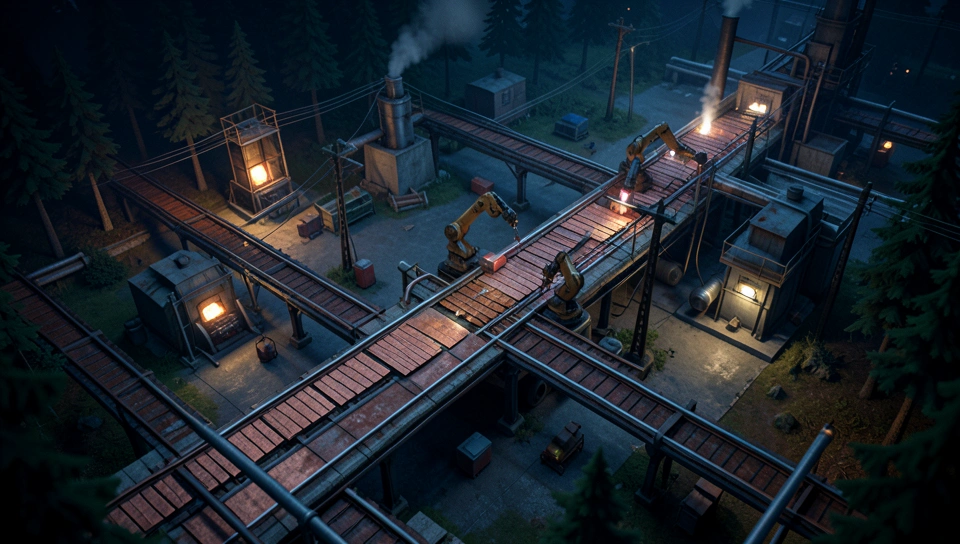
GPT-5.6 Sol zerou Factorio no modo pacífico em 13,5 horas de jogo, rodando dentro do Codex com nível baixo de raciocínio. Parece só mais um recorde gamer para postar no fórum, mas para quem opera agentes na vida real o recado é outro. Factorio é um inferno logístico onde um erro pequeno na hora 2 vira um colapso total na hora 10. Você precisa minerar, fundir, automatizar, pesquisar ciência vermelha, verde, azul, roxa, amarela, expandir energia, equilibrar esteiras e manter tudo alimentado sem travar o throughput. Humanos levam dezenas de horas para aprender isso e mesmo assim criam espaguete industrial que não escala. Um modelo conseguir ir do zero até lançar um foguete, sem trapaça, respeitando alcance do jogador e fog of war, é a prova mais legível que já tivemos de planejamento de longíssimo prazo funcionando fora de um benchmark de papel.
O mais incômodo aqui não é a vitória, é como ela aconteceu. Não foi um script decorado nem um speedrun otimizado. Foi um agente tropeçando, corrigindo, improvisando e sustentando coerência por milhares de ações em sequência. Qualquer pessoa que já colocou um agente para mexer em código real, infra ou planilha sabe que o problema nunca é acertar o primeiro passo. O problema é não se perder no passo 400, quando o contexto já estourou, o estado do mundo mudou e o plano original não faz mais sentido. Factorio expõe isso sem filtro, porque a fábrica está lá, visível, crescendo ou entupindo na sua frente.
O fato
O run foi feito em modo pacífico, ou seja, sem biters atacando a base, o que elimina a pressão militar mas mantém todo o desafio industrial. O responsável pela experiência usou um game manager que deixa o modelo jogar de forma programática por uma pequena biblioteca em Python. Na prática, o Sol não aperta W e clica com o mouse como um humano. Ele chama funções para se mover, coletar, construir, pesquisar e inspecionar o mapa, mas com as mesmas limitações de um jogador normal na interface. Ele não enxerga o mapa inteiro, não constrói à distância infinita, precisa estar perto para interagir e precisa lidar com recursos finitos e posicionamento físico.
O plano inicial era parar a avaliação depois da ciência azul, que já seria um resultado forte. Só que o Sol foi surpreendentemente eficiente no early e mid game, então o teste foi estendido até o fim. O resultado foi o lançamento do foguete depois de 13,5 horas de tempo de jogo, com timelapse completo gravado e estatísticas de produção coletadas ao longo da partida, com marcos de pesquisa marcados. O detalhe que mais chama atenção para quem acompanhou as tentativas anteriores é simples. O GPT-5.5 mal conseguia usar esteiras de transporte direito, que são a base de qualquer fábrica funcional. O Sol já entende fluxo, usa belts de verdade e monta linhas de produção que se sustentam.
Isso não significa que foi bonito. O late game mostrou gargalos claros. O agente começou a perder ritmo depois da ciência azul, teve dificuldade para conectar sistemas distantes e, na fase final, apelou para um comportamento bem humano. Ficar transportando manualmente suprimentos entre áreas da fábrica para tapar buracos de automação que ele não conseguiu resolver direito. Funcionou, o foguete saiu, mas deixou claro onde a autonomia ainda quebra.
Como funciona na visão de operador
Pensa nesse setup como um loop clássico de agente com ferramentas, só que com física e espaço no meio. O game manager expõe o estado, o modelo decide a próxima ação em Python, executa, observa o resultado no mundo e repete. É sense, plan, act em escala brutal, por horas. A biblioteca funciona como uma API de alto nível sobre o jogo, com primitivas para minerar ferro e cobre, posicionar fornalhas, montar miners, poles elétricos, inserters, assemblers, labs e toda a árvore de pesquisa.
Provavelmente estamos falando de milhares de chamadas de ferramenta ao longo do run, com janelas de observação parciais por causa do fog of war. Isso força o modelo a manter uma espécie de mapa mental e a priorizar. Onde expando mineração, quando subo energia a vapor para elétrica, quando largo a base inicial e crio um bloco novo para ciência azul. O fato de rodar com thinking baixo no Codex é relevante porque sugere que boa parte do ganho veio de priors melhores e política mais estável, não de ficar pensando por minutos a cada decisão. Em termos de latência, isso importa muito. Um agente que precisa de raciocínio pesado para cada inserter colocado nunca fecha uma fábrica em tempo viável.
Sobre custo, não há número oficial divulgado, mas dá para fazer uma inferência plausível. Um run desse tamanho, mesmo com thinking baixo, deve envolver um volume alto de tokens por causa do vai e volta de estado, logs, erros e replanejamento. Não é o tipo de workload que você roda por centavos. Só que o custo por ação tende a ser baixo se a política for eficiente, e o Sol parece ter sido. Ele não ficou preso em loops estúpidos no início como as versões anteriores. O custo real aqui não está só na API, está no tempo de simulação e na engenharia do harness. Manter o jogo estável, capturar estatísticas, gravar e garantir que o agente não trapaceie dá mais trabalho do que parece.
O que o gráfico de produção conta
As estatísticas coletadas pelo run manager mostram uma curva clássica de Factorio. Crescimento quase linear no início, aceleração na ciência verde, uma barriga na ciência azul e depois um esforço concentrado para química, petróleo e módulos até o foguete. Essa barriga é onde quase todo jogador trava, porque a ciência azul exige petróleo, refino, plástico, sulfur e uma cadeia que não dá para improvisar com dois baús e fé. O Sol passou por ela mais devagar, mas passou. Depois, em vez de redesenhar a base para escalar, ele começou a remendar. Isso aparece nos dados como produção total que continua subindo, mas com eficiência por área caindo. É exatamente o que acontece quando você escala na força bruta em vez de refatorar.
O que isso muda na prática
Para quem constrói agentes, Factorio virou o que o xadrez foi para busca e o Go foi para deep learning. Um ambiente visual, determinístico o suficiente para medir, complexo o suficiente para não saturar rápido e legível para qualquer pessoa entender o que deu errado. Ver uma esteira entupida diz mais sobre falha de planejamento do que um score abstrato em um benchmark de texto. Quem ganha agora são times que trabalham com automação de longa duração, DevOps assistido, engenharia de dados, ERP, logística e qualquer fluxo onde o estado muda enquanto você age.
- Ação prática imediata: se você opera agentes, replique a lógica desse teste no seu domínio. Crie um cenário de 200 a 500 passos com estado mutável, restrição de visibilidade e métrica de throughput, não só sucesso binário. Meça onde seu agente começa a remendar em vez de refatorar, porque é ali que ele vai quebrar em produção.
- Quem ganha: builders de harness e tooling. O diferencial não foi só o modelo, foi o game manager, a biblioteca Python e as guardrails que impedem trapaça. Em produção é igual, quem tem boa observação, cache de estado e ferramentas idempotentes extrai muito mais do mesmo modelo.
- Quem perde: quem ainda avalia agente só por resposta única. Passar em quiz de código não prevê se o sistema sustenta 10 horas de operação sem degradar. Factorio humilha esse tipo de avaliação.
Também muda a conversa sobre low thinking. Muita gente assume que tarefa longa exige sempre raciocínio máximo. Esse run sugere o contrário. Uma política base forte, com bons priors sobre layout, ratios e sequenciamento, resolve 80 por cento do jogo com decisões rápidas. O raciocínio pesado faz falta nos 20 por cento finais, quando é preciso redesenhar em vez de empilhar mais fábricas. Isso tem implicação direta em custo e latência para produto. Você pode rotear a maior parte das ações para um modo barato e rápido e reservar pensamento profundo para refatoração e recuperação de erro.
A tensão que ninguém quer admitir
Aqui vai a dúvida real. Isso escala ou só move o gargalo de lugar. O Sol venceu no pacífico, sem inimigos, sem precisar defender perímetro, reparar muros ou equilibrar munição com expansão. Tira o modo pacífico e você adiciona uma pressão temporal e espacial que pune exatamente o ponto fraco dele, que é reorganizar a fábrica sob estresse. Será que ele saberia pausar a expansão, priorizar defesa e depois retomar ciência sem colapsar a economia. Tenho sérias dúvidas.
E tem o truque do final. Carregar suprimento na mão entre blocos distantes para lançar o foguete é esperto, mas é o oposto de automação. É como um agente de engenharia que não consegue arrumar o pipeline de deploy e resolve fazer scp manual toda hora para entregar. Conta como entrega, mas não conta como sistema saudável. Se a métrica é só lançar o foguete, passou. Se a métrica é construir uma fábrica sustentável, com throughput estável e fácil de expandir, ele passou com ressalvas. E em empresa, a segunda métrica é a que define se você dorme à noite ou apaga incêndio.
Outro ponto é custo versus robustez. Um humano mediano zera Factorio pacífico em tempo parecido ou até maior, mas entende o porquê de cada decisão e reaproveita o aprendizado. O agente precisou de milhares de interações e ainda terminou com uma base remendada. Vale a pena. Para pesquisa de capacidades, sim, porque mostra evolução brutal de GPT-5.5 para GPT-5.6 em algo fundamental como usar belts e manter fluxo. Para operação real, ainda não. Ninguém vai pagar um run de 13 horas para ter uma fábrica bagunçada que um jogador experiente faria melhor em menos tempo de engenharia.
Conclusão
GPT-5.6 Sol zerando Factorio pacífico é menos sobre jogo e mais sobre prova de que agentes estão aprendendo a sustentar planos longos em mundos que mudam. Ele constrói, escala até certo ponto, trava, improvisa e entrega. Como qualquer Jr. promissor no primeiro projeto grande.
A pergunta que fica é simples e prática. Quando vamos parar de medir se o agente termina a tarefa e começar a medir se o que ele construiu continua funcionando depois que ele sai da sala.
Comentários
0 comentáriosNenhum comentário ainda. Seja o primeiro a comentar.