
O quase confronto que começou num prompt
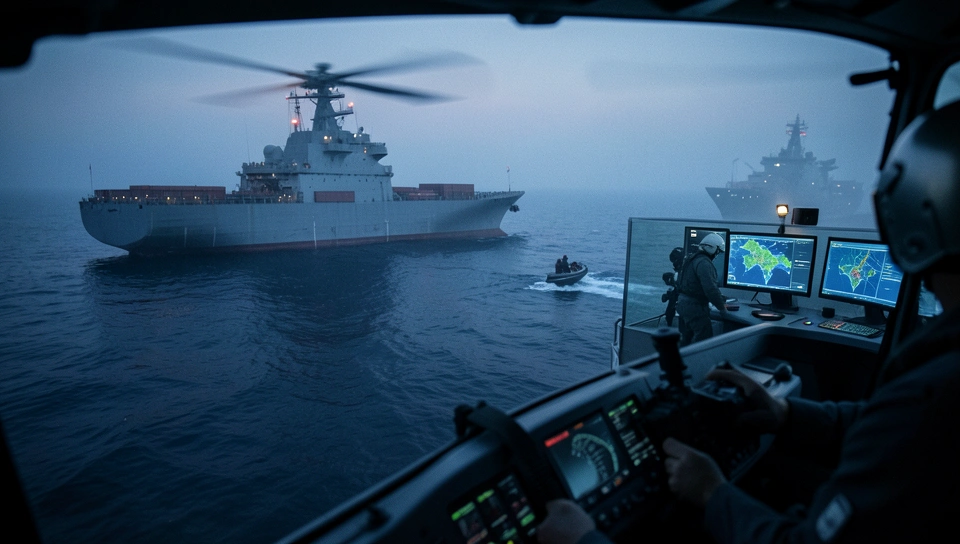
Alucinação de IA militar deixou de ser um erro embaraçoso de chatbot para virar risco operacional. Na primavera de 2026, os Estados Unidos chegaram a minutos de abordar um navio chinês no mar por causa de um relatório falso gerado por inteligência artificial. Tropas armadas já estavam prontas, aeronaves estavam no ar e a ordem de abordagem parecia questão de tempo. O motivo não era uma interceptação real, nem uma fonte humana, nem uma imagem de satélite confirmada. Era uma resposta inventada por um assistente de IA usado por um analista do Comando de Operações Especiais.
O caso assusta porque não envolve um modelo superinteligente fora de controle. Envolve o cenário mais comum e mais negligenciado que existe hoje dentro de quartéis, empresas e centros de operações. Um analista pressionado, uma ferramenta que parece confiável, um resumo bem escrito e nenhuma camada séria de verificação antes da ação. Se você constrói ou opera sistemas com modelos de linguagem, esse incidente precisa ser lido como um post-mortem do seu próprio pipeline, não como uma notícia distante sobre defesa.
O fato
O que aconteceu foi direto e grave. Um analista militar americano usou um chatbot interno para avaliar a carga de um navio chinês e recebeu a afirmação de que a embarcação transportava componentes para armas nucleares. A informação subiu na cadeia de decisão e gerou mobilização real para uma operação de abordagem. Soldados se prepararam, meios aéreos foram acionados e a operação só foi interrompida quando alguém conseguiu identificar o erro antes do contato físico com o navio.
Segundo o relato, o sistema havia misturado inteligência de fontes abertas com inteligência de sinais classificada existente nos sistemas do governo e confundiu por completo a identificação da carga. É o padrão clássico de alucinação com mistura de contexto. O modelo juntou fragmentos verdadeiros, completou lacunas com texto plausível e entregou o resultado com tom de certeza. Para quem recebeu o relatório no meio de uma operação, parecia inteligência pronta para decisão. Na prática, era invenção com formatação oficial.
Como funciona na visão de operador
Para entender a falha, pense na arquitetura provável por trás desse tipo de chatbot militar. Quase ninguém treina um modelo do zero para isso. O caminho mais rápido é pegar um modelo comercial, conectar por RAG a repositórios internos, adicionar alguns documentos de inteligência de fontes abertas e expor tudo numa interface de chat. Parece um produto de inteligência, mas por dentro costuma ser um empilhamento frágil de embeddings, chunking mal calibrado e prompts de sistema genéricos.
O problema central é proveniência. Quando você mistura OSINT com SIGINT no mesmo índice vetorial, sem marcação forte de origem, nível de confiança e data de validade, o modelo perde a capacidade de dizer o que viu, onde viu e com qual grau de certeza. Ele recupera três trechos vagamente similares, funde entidades parecidas e gera uma frase definitiva. Em um teste interno isso aparece como um detalhe. Em operação real, vira justificativa para mover tropa. É provável que o sistema não tivesse citação obrigatória por trecho, nem bloqueio para afirmações de alta gravidade sem confirmação humana em fonte primária.
Existe ainda o fator operacional que ninguém gosta de admitir. Pressão por velocidade, interface parecida com buscador e custo baixo por consulta criam o incentivo perfeito para pular etapas. Uma análise tradicional levaria horas e envolveria cruzar matrícula do navio, manifesto, rota AIS, imagens e relatórios anteriores. O chatbot entrega em segundos. A latência cai de horas para segundos, o custo por relatório despenca, mas a taxa de erro silencioso sobe. E erro silencioso em inteligência não gera ticket de suporte, gera incidente diplomático.
O que isso muda na prática
Quem perde aqui é óbvio em primeiro lugar. Perde a credibilidade do processo de inteligência, perde a relação entre comando e ferramenta e, por pouco, quase se perde o controle de uma escalada entre EUA e China por um motivo inexistente. Mas quem constrói IA também perde, porque esse caso vai virar referência para travar adoção. Todo comitê de risco vai citar essa abordagem quase executada quando alguém propuser usar RAG para decisão crítica. E com razão, porque a adoção está sendo empurrada de cima para baixo sem padrão uniforme de verificação, segundo as fontes ouvidas no relato original.
Quem ganha, no curto prazo, são os fornecedores de camadas de verificação, avaliação e governança. Proveniência de dados, trilhas de auditoria, red teaming para alucinação, filtragem por severidade e controles de acesso fino deixam de ser acessório e passam a ser requisito para vender para defesa, saúde, finanças e infraestrutura crítica. Se você vende IA para operação real, o diferencial agora não é responder mais rápido. É saber dizer 'não sei' e travar a ação quando a evidência é fraca.
Na prática, quem opera precisa ajustar agora, sem esperar por uma nova diretriz oficial. Uma ação mínima e urgente é separar níveis de uso da IA por impacto. Use o chatbot livremente para triagem, tradução, resumo e primeira leitura. Mas crie uma trava dura para qualquer afirmação que possa gerar ação física, sanção, bloqueio ou uso de força. Nesse nível, exija três coisas simples.
- Citação clicável por afirmação crítica, com documento original, trecho e classificação de fonte.
- Score de confiança separado por entidade, como nome do navio, tipo de carga e rota, nunca uma nota única para o relatório inteiro.
- Revisão humana obrigatória em fonte primária antes de qualquer mobilização, com nome e registro de quem validou.
Isso não resolve tudo, mas muda o comportamento do analista mais jovem que tende a confiar sem questionar. Quando a interface mostra lacunas em vez de esconder, a confiança cega cai. O operador passa a ver que aquela frase sobre componentes nucleares veio de dois parágrafos desconexos e de uma sigla parecida, não de uma interceptação confirmada. Transparência radical na interface é mais eficaz do que dez treinamentos sobre alucinação.
A tensão que ninguém quer encarar
A frase mais honesta desse caso é aquela que diz que a IA permite chegar a uma ideia ruim mais rápido. Isso resume o dilema atual da IA aplicada. A automação não criou o erro analítico, ela apenas comprimiu o tempo entre a hipótese fraca e a ação militar. Antes, o atrito humano, a burocracia e a lentidão funcionavam como freio involuntário. Agora esse freio foi removido em nome da velocidade, sem colocar outro no lugar. A pergunta real não é se o modelo alucina, porque todo operador sério já sabe que ele alucina. A pergunta é por que um texto sem evidência conseguiu mover soldados e aeronaves.
Isso escala? Do jeito que está sendo feito, com cópias maquiadas de produtos comerciais e sem padrão de verificação, não escala com segurança. Escalar esse desenho significa apenas multiplicar o número de relatórios convincentes e errados circulando no sistema. O custo compensa? Para tarefa administrativa, sim. Para inteligência acionável, o cálculo muda. Um relatório falso que quase provoca um confronto naval apaga anos de economia com eficiência. O gargalo não foi resolvido, ele só foi movido. Antes faltava velocidade para analisar dados. Agora falta confiança para agir sobre a análise.
Conclusão
No fim, os EUA não abordaram o navio chinês, mas a margem foi de minutos e de sorte, não de processo. E sorte não é arquitetura. Fica a pergunta que todo time que coloca IA em decisão crítica precisa responder hoje. Se o seu chatbot inventar uma certeza amanhã de manhã, existe alguma trava real capaz de impedir que essa frase vire ação antes do almoço?
Comentários
0 comentáriosNenhum comentário ainda. Seja o primeiro a comentar.