
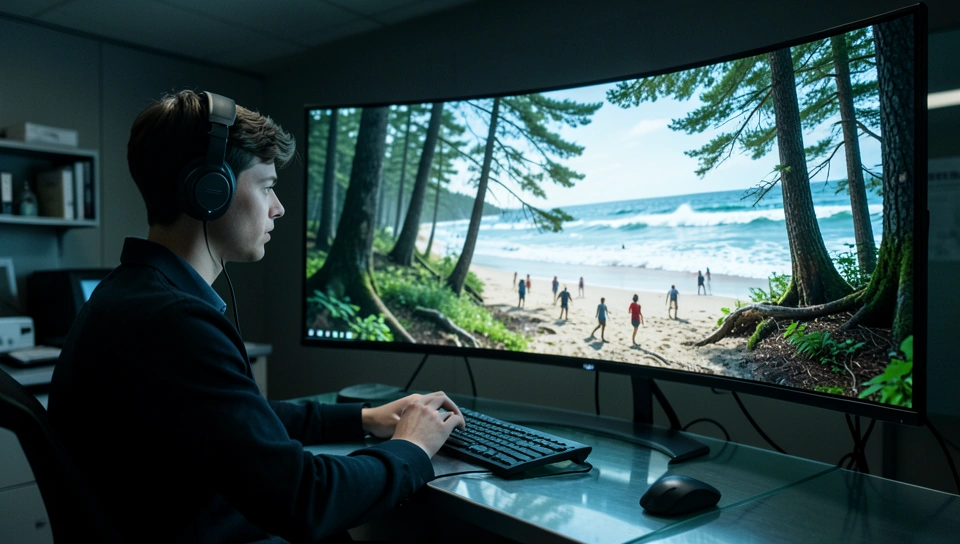
O problema nunca foi gerar vídeo, foi manter o mundo de pé
Genie 4 chegou com uma promessa que quem já tentou construir simulação interativa conhece bem. Gerar um clipe bonito de 10 segundos é fácil hoje, difícil é manter um mundo coerente por 10 minutos enquanto o usuário mexe em tudo, muda o clima, atravessa a cena e fala com os personagens sem quebrar a física ou a lógica. É exatamente nesse ponto que o novo modelo de simulação de mundos do Google DeepMind tenta atacar, com geração em tempo real, áudio nativo e personagens que reagem e conversam. A pergunta que interessa para quem opera não é se o demo impressiona, e sim se dá para usar isso como ambiente de teste, ferramenta de criação ou base para agentes.
Depois de testar muita geração de vídeo e muito ambiente de game procedural, aprendi a desconfiar de realismo em trailer. O que chama atenção aqui é outro detalhe. O Genie 4 não vende apenas fidelidade visual, ele vende continuidade. Você dá um comando em linguagem natural no meio da simulação, o mundo se adapta, e um sistema de raciocínio acompanha o que está acontecendo para não deixar a história desandar. Se isso funcionar fora do ambiente controlado, muda bastante coisa para quem treina robôs, cria experiências interativas ou precisa de dados sintéticos variados.
O fato: o que o DeepMind realmente lançou
O DeepMind anunciou o Genie 4 como sua nova geração de world model, com foco em realismo sem precedentes e simulação interativa em tempo real. O modelo é nativamente multimodal. Isso significa que ele gera ao mesmo tempo imagem, movimento, sons ambientes como vento e ondas, trilhas simples e diálogo interativo entre personagens. Os vídeos divulgados são gravações de interações reais, com controle por teclado para navegação e câmera, além de prompts de texto para guiar a cena enquanto ela evolui.
O lançamento foi feito como research preview para testadores confiáveis, com expansão planejada para assinantes do Google AI Ultra dentro do Project Genie e para parceiros de acesso antecipado via Gemini API e Google AI Studio. Na prática, ainda não é um produto aberto. É uma fase de coleta de feedback, ajuste de segurança e entendimento de custo operacional antes de escalar. Para desenvolvedores, o recado é claro. A interface futura deve passar pelo ecossistema Gemini, e não como um modelo isolado que você baixa e roda localmente.
Como funciona: Genie 4 mais Gemini por baixo do capô
Pensando como operador, o Genie 4 parece menos um gerador de vídeo e mais um stack de simulação com três camadas. Na base está a geração de mundo em tempo real, responsável por pixels, geometria implícita, física e movimento. No meio entra o que o DeepMind chama de ancoragem no mundo real, com o Gemini Omni ajudando a manter aparência e comportamento plausíveis. No topo entra o raciocínio, com outros modelos Gemini observando a cena, dividindo objetivos em etapas e verificando se cada passo foi cumprido. É uma arquitetura de geração guiada, não geração pura.
O exemplo técnico mais revelador é o uso do Gemini 3.8 Flash como agente no loop. Enquanto o Genie 4 gera quadros, o Flash observa frames de entrada, acompanha o progresso de uma tarefa, adapta o plano se o usuário intervém e comanda ajustes de câmera, clima ou objetos. Isso lembra muito um game engine onde o renderer é neural e o game logic é um LLM com visão. Faz sentido para latência, porque um modelo Flash é otimizado para resposta rápida, mas ainda levanta dúvidas sobre custo por minuto simulado. Você está pagando por dois modelos rodando juntos, um gerando e outro vigiando.
Áudio nativo e física em tempo real
O áudio nativo é o avanço mais subestimado. Não é trilha colocada por cima, é som gerado junto com o mundo. Isso exige sincronia fina entre evento visual e evento sonoro, como passos, colisão, vento nas árvores ou fala. Em termos de implementação, é provável que exista um head de áudio condicionado nos mesmos latentes de cena, o que aumenta a demanda de memória e inferência. Para quem já operou TTS em tempo real, sabe que diálogo interativo com latência abaixo de 800 milissegundos já é desafio. Aqui o desafio é maior, porque a fala precisa fazer sentido com o contexto espacial e narrativo.
Na física, o salto está em aerodinâmica, colisões e principalmente movimento humano. Personagens que andam, desviam, reagem e podem ser controlados em tempo real sempre foram o calcanhar de aquiles da simulação neural. O Genie 4 aparenta usar priors fortes de movimento aprendidos de vídeo e captura, combinados com correção contínua do Gemini para evitar deslizes, atravessamentos ou poses impossíveis. Minha inferência técnica, sem confirmação oficial de números, é que a resolução e o frame rate devem ser adaptativos para segurar o tempo real, com upscale posterior. Nada disso vai rodar barato em larga escala no começo, e o acesso via API deve vir com limites rígidos de sessão e fila.
O que isso muda na prática
Quem ganha primeiro não é o gamer, é quem precisa de ambiente. Times de robótica e de agentes embodied vivem o problema de treinar em simuladores pobres que não transferem para o mundo real. Um mundo gerável por prompt, com variação infinita de iluminação, objetos, pessoas e sons, pode reduzir o gap entre simulação e realidade para testes de navegação, manipulação e interação social. O segundo grupo beneficiado são criadores independentes e estúdios pequenos, que poderão prototipar fases, cinemáticas interativas e NPCs com diálogo emergente sem montar um time inteiro de engine e áudio.
- Prototipação de games: teste ideias de nível com prompt em vez de montar cena na mão, valide mecânica antes de investir em arte final.
- Treino de agentes: crie cenários multi-etapas com falhas e intervenções para avaliar planejamento, não só percepção.
- Conteúdo interativo: explore narrativas onde o usuário muda clima, câmera e personagens sem quebrar a história.
- Quem perde espaço: pipelines de stock de vídeo, simulação 3D manual simples e demos estáticas de produto tendem a perder valor rápido.
A ação prática para agora é simples e direta. Se você trabalha com agentes, robótica ou games, monte um benchmark próprio de coerência longa antes de se empolgar. Separe 10 tarefas multi-etapas como atravessar uma sala, pegar um objeto, entregar para um personagem e reagir a uma mudança de clima, e meça em quantas o mundo se mantém consistente por mais de 3 minutos. Quando o acesso ao Project Genie ou à Gemini API liberar, rode esse mesmo teste. Isso vai te dizer mais sobre utilidade real do que qualquer vídeo de demonstração, e já deixa seu pipeline de avaliação pronto para dados sintéticos audiovisuais.
A tensão: isso escala ou só move o gargalo?
Aqui está minha dúvida real depois de ver a arquitetura. O Genie 4 resolve o problema da fidelidade de curto prazo, mas cria um problema novo de supervisão contínua. Manter um Gemini observando cada frame para corrigir rumo é elegante no paper, mas caro em produção. Cada minuto de simulação vira minutos de inferência de vídeo mais inferência de visão e linguagem mais síntese de áudio. A conta fecha para pesquisa e para protótipo premium, mas fecha para um jogo com 10 mil usuários simultâneos ou para um loop de treino de robô que precisa de milhões de episódios. Tenho sérias dúvidas.
Tem outro ponto que pouca gente comenta. Coerência guiada por LLM tende a funcionar bem quando o usuário colabora, e a degradar quando o usuário trolla. O que acontece quando 20 pessoas dão comandos contraditórios, ou quando alguém força física impossível por 5 minutos. O sistema corrige, trava ou alucina. E quem define o que é correção válida. Para uso em treinamento de agentes críticos, isso importa muito, porque um simulador que inventa física para agradar o prompt pode ensinar o comportamento errado. O valor do Genie 4 vai depender menos do realismo e mais das guardrails, dos limites de sessão, da reprodutibilidade e do preço por hora simulada.
Conclusão
Genie 4 é o passo mais convincente até agora rumo a mundos neurais jogáveis, com som e interação de verdade. A questão que fica é operacional. Quanto custa manter esse mundo de pé por tempo suficiente para ser útil.
Comentários
0 comentáriosNenhum comentário ainda. Seja o primeiro a comentar.