
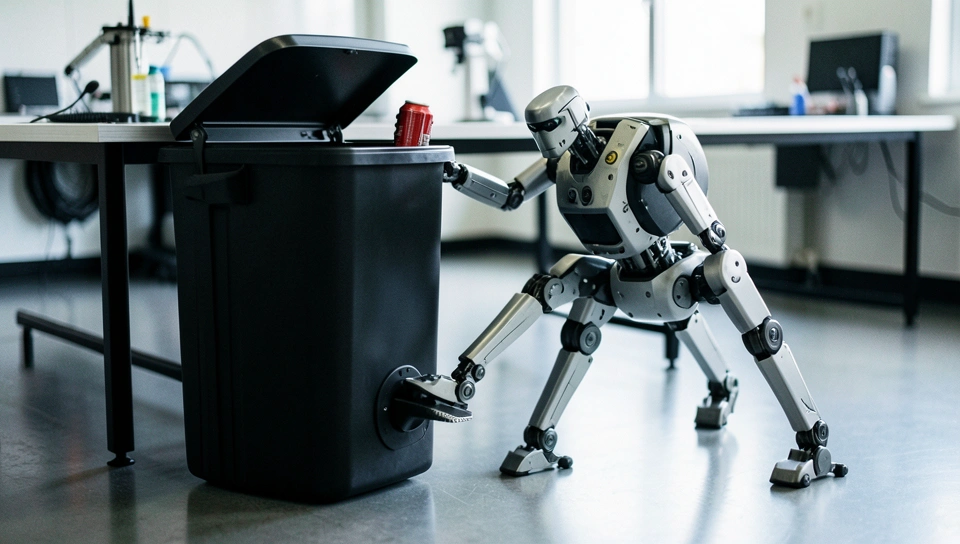
O pedal da lixeira que separa demo de operação real
Gemini 4 Argon começa exatamente onde a maioria dos projetos de robótica trava. Não é reconhecer uma lata de refrigerante na mesa, é entender que para jogar aquela lata fora você precisa pisar com o pé certo no pedal certo, com a força certa, enquanto segura a lata sem amassar e sem derrubar o resto. Quem já tentou colocar um quadrúpede para fazer manipulação móvel sabe o quanto isso dói. Uma perna vira pé de apoio, outra vira atuador, o centro de massa desloca e qualquer erro de poucos centímetros transforma uma tarefa banal em queda. É nesse ponto, no contato físico com o mundo, que o novo modelo da Google DeepMind quer atuar.
O fato é simples e ao mesmo tempo grande. Argon foi apresentado como um modelo de raciocínio físico de propósito geral, com salto em compreensão física, geração de código e raciocínio visual semântico. Na prática, isso significa que ele não só descreve a cena, ele planeja ações, escreve o código que executa essas ações e verifica o resultado em loop fechado. O número que ancora a conversa é o benchmark Embodied Reasoning, o ERQA, que testa resolução de problemas espaciais em ambientes 3D usando puro raciocínio. Argon marcou 87 por cento, acima de todos os outros modelos de fronteira avaliados até agora.
O fato sem enfeite
O que a DeepMind mostrou não foi um paper seco. Foram dois fluxos completos atravessando a pilha da robótica. No primeiro, Argon controla um quadrúpede Spot com 12 graus de liberdade nas pernas mais 6 graus no braço para aprender uma habilidade nova. Tem uma lata atrás do robô e outra sobre uma mesa preta à esquerda. A ordem é pegar as duas e descartar em uma lixeira preta de pedal. Antes de pisar, o modelo precisa conferir nas câmeras frontais se o pé dianteiro direito está centrado no pedal e usar uma verificação com dois agentes, um para o pé no pedal e outro para a mão dentro da lixeira, antes de soltar a lata. Parece detalhe, mas é a diferença entre simulação bonita e operação que não quebra a louça.
No segundo exemplo, o cenário é mais contido e talvez mais revelador para quem constrói. Um braço robótico simples precisa colocar uma caneca caída de volta em pé e colocar um guardanapo amassado dentro dela. Argon trabalha com uma imagem da câmera de pulso anotada e um arquivo de observação com posição do efetuador, estado de grasp e workspace. Ele opera por turnos, cada turno é uma frase de observação seguida de um comando curl para primitivas como look_at, grasp, place, goto, move_by e place_until_contact. A imagem tem grade de 2 cm, eixo X para longe da base, Y para a esquerda, Z para altura, além de mira ciano para o centro da garra e linha verde para orientação da caneca. É teleoperação transformada em código gerado por modelo.
Como funciona na visão de quem opera
Arquiteturalmente, Argon parece funcionar como um orquestrador VLM que cospe políticas como código. Ele não envia torques diretamente, ele chama uma API local de habilidades. No caso do Spot, a habilidade de manipulação móvel recebe alvos de pé e mão em 3D. No caso do braço, o servidor em 127.0.0.1 expõe plano e observação via HTTP, e o modelo decide a granularidade logo no primeiro turno. Grosso com 2 a 4 chamadas para tarefas fáceis, intermediário com verificação de pairar antes do grasp com 4 a 7 chamadas, ou servoamento visual fino com 8 a 20 chamadas para ajuste contínuo. Essa escolha explícita de orçamento de chamadas já diz muito sobre custo e latência.
O pulo interessante está na camada de verificação. Para a lixeira de pedal, Argon cria primeiro um gêmeo digital articulado em MuJoCo para ensaiar o movimento antes de pisar no pedal físico. Isso reduz risco e permite testar contato, atrito e abertura da tampa sem hardware. Depois, em execução, ele usa o swarm de verificação com dois agentes para checar alinhamento do pé e da mão em 3D. Para o braço, a verificação é visual a cada turno, com reobservação se o status voltar como grasp_failed. É plausível, embora não confirmado em todos os detalhes públicos, que o modelo esteja combinando estimativa de pose, deprojeção de pixel para mundo e checagem semântica do tipo isso parece centrado, isso parece dentro. O custo aqui não é só inferência do modelo grande, é ida e volta de rede, render de grade, captura de câmera e tempo de robô parado esperando o próximo token.
Latência, custo e onde aperta
Se você opera esse tipo de stack, já fez a conta de cabeça. Cada turno de VLM com imagem de alta resolução mais JSON pode levar de um a alguns segundos dependendo do tamanho do modelo e da região. Multiplique por 15 turnos para uma tarefa de endireitar caneca e você tem algo entre 30 segundos e dois minutos só de raciocínio, sem contar movimento. Para um demo gravado, ótimo. Para uma linha com takt de 12 segundos, inviável. O caminho provável é usar Argon como gerador de skill e verificador, depois destilar para políticas menores ou cachear trajetórias para casos repetidos. A DeepMind não abriu custo por tarefa, mas dá para inferir que o valor está menos em controlar cada junta em tempo real e mais em gerar e validar programas robustos que depois rodam perto do edge.
O que isso muda na prática
Quem ganha primeiro é o time que vive no meio da pilha. Engenheiro de robótica que hoje gasta dias calibrando retículo, ajustando yaw e pitch de grasp e escrevendo recovery para falha de pega passa a delegar parte desse trabalho braçal para linguagem natural mais visão. O fluxo de criar gêmeo digital em MuJoCo por prompt, testar o pedal virtualmente e só então ir para o hardware economiza hardware quebrado e horas de bancada. Laboratórios de pesquisa, integradores e times de automação que precisam prototipar habilidades novas rápido tendem a acelerar muito. Quem perde, pelo menos no curto prazo, é o fluxo puramente manual de programação por waypoints e a ideia de que percepção se resolve só com detector de objetos. Entender que o pedal precisa de verificação centrada no pé muda o padrão de qualidade esperado.
Na prática, o que você precisa ajustar agora é disciplina de execução. Argon só funciona bem se a interface for limpa. Defina primitivas pequenas e observáveis, retorne status honesto como holding, ee_pos e grasp_failed, mantenha calibração da câmera de pulso e versione o workspace. Uma ação prática para testar ainda esta semana é replicar o harness visual em um braço simples. Coloque uma câmera no pulso, desenhe uma grade métrica sobre a imagem, exponha três endpoints, observação, plano e olhar, e force o modelo a responder sempre com uma frase de observação mais um comando. Meça taxa de sucesso, número de turnos e tempo por tarefa em dez tentativas com a caneca em posições diferentes. Se o número de turnos cair e a taxa subir quando você adiciona verificação de pairar antes do grasp, você reproduziu o ganho central do Argon sem precisar do modelo maior.
- Mapeie suas tarefas por contato físico e não por categoria semântica, pisar, empurrar, inserir e despejar têm dinâmicas diferentes.
- Separe raciocínio lento de controle rápido, use o modelo grande para gerar e verificar e uma política pequena para executar em tempo real.
- Registre cada falha com imagem, pose e primitiva usada, esse log vira seu dataset de recuperação.
A tensão que ninguém pode ignorar
Aqui entra a dúvida de operador. Os 87 por cento no ERQA impressionam, mas raciocínio puro em benchmark não é contato físico com ruído, escorregão e latência de rede. O demo do Spot funciona porque tem verificação dupla e gêmeo digital, ou seja, mais computação e mais engenharia ao redor, não menos. Isso escala para um galpão com 50 robôs variados, iluminação ruim e pedal de lixeira diferente em cada andar. Talvez sim, se o modelo generalizar física e não só aparência, mas o custo de 10 a 20 chamadas de VLM por tarefa simples ainda pesa. Em algum ponto, a conta de tokens e tempo supera o salário de programar a skill uma vez e replicar.
Tem outro ponto incômodo. Argon parece mover o gargalo em vez de eliminar. Antes o problema era escrever código de manipulação, agora o problema vira garantir que a verificação visual não alucine. Dizer que o pé está centrado no pedal a partir de uma imagem frontal com oclusão parcial exige calibração e confiança calibrada. Se o verificador aprova um alinhamento errado, o robô pisa torto, a tampa abre pela metade e a lata cai fora. Em teleoperação crítica, quem assina embaixo quando o swarm erra. A resposta honesta é que ainda precisamos de camadas clássicas, limites de força, checagem de contato, envelope de segurança, mesmo com um modelo muito bom gerando código. Inteligência física não dispensa física de verdade.
Conclusão prática
Gemini 4 Argon é menos um robô novo e mais um novo jeito de programar robôs, com linguagem, visão e código verificável no mesmo loop. Funciona quando o problema é variabilidade de cena e contato leve, e cobra seu preço em latência e custo de inferência. Vale testar o harness visual no seu braço parado e medir turnos até sucesso. Será que raciocínio físico generalista sustenta operação contínua ou vai virar gerador de demos caros que depois precisam ser destilados para rodar de verdade.
Comentários
0 comentáriosNenhum comentário ainda. Seja o primeiro a comentar.