
Atendimento por voz ainda parece robocall com pressa
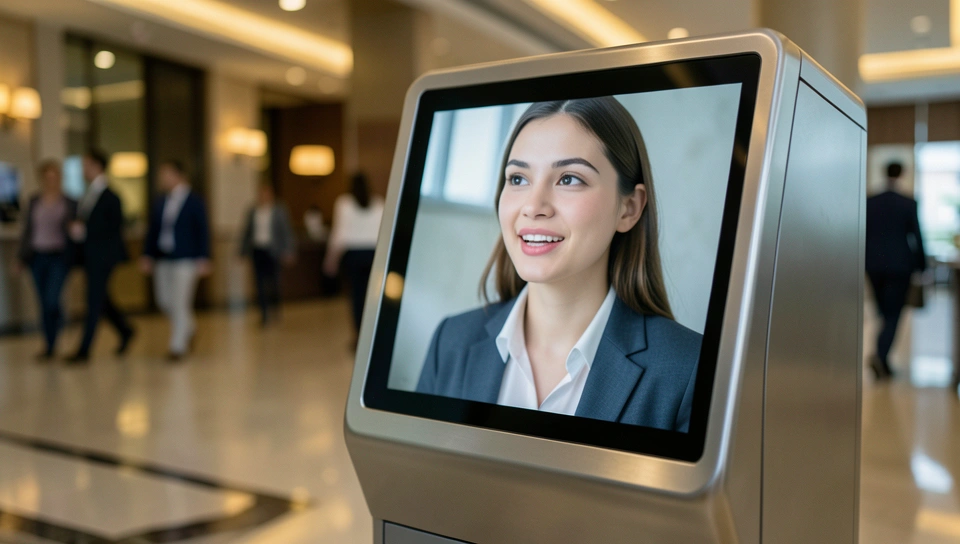
Gemini 3.8 Live with Live Avatar tenta quebrar exatamente essa sensacao. Uma semana depois de lancar o Gemini 3.8 Live, o Google colocou um rosto na conversa. Agora a IA nao so fala com voce, ela olha para voce, mexe a boca em sincronia, muda a expressao e mantem o turno de fala sem aquele silencio travado de bot tradicional. A promessa e transformar dialogo por voz em presenca visual quase em tempo real, direto dentro do Gemini Enterprise.
O fato, sem enfeite
O que foi lancado e simples de entender. O Live Avatar combina geracao de video em tempo quase real com os modelos nativos de dialogo ao vivo do Gemini 3.8. Ele escuta, enxerga por camera ou compartilhamento visual, raciocina e responde com audio e video sincronizados. O Google fala em lip-sync preciso, expressoes naturais e troca de turnos fluida. Ja esta disponivel para empresas via Gemini Enterprise, com biblioteca de avatares prontos e opcao de avatar customizado a partir de uma imagem de referencia, essa ultima apenas via allowlist para clientes enterprise.
O outro ponto central e idioma. O recurso faz sincronizacao nativa de fala para fala em 97 idiomas, adaptando boca e expressao sem perder fidelidade do video. Na demo de hotel que circula, o avatar faz check-in, chama tools no fundo, confirma dados e continua falando sem pausar a conversa. Parece demo bonita, e e. Mas o recado para quem opera e outro: isso e um agente multimodal com rosto, nao um video gerado solto.
Como funciona na visao de quem opera
Na pratica, voce tem tres camadas rodando juntas. Primeiro, entrada multimodal simultanea de audio e video. O modelo precisa entender o que ouve e o que ve ao mesmo tempo, o que exige janela de contexto rapida e pipeline de streaming bem ajustado. Segundo, saida sincronizada de fala e video. Nao e so TTS com um avatar por cima. O movimento labial precisa acompanhar fonemas em tempo real, em varios idiomas, sem drift visual. Terceiro, raciocinio com execucao assincrona de tools. Enquanto o avatar fala, o modelo dispara chamadas de API em background, busca reserva, consulta CRM, valida identidade, e volta com a resposta sem quebrar o fluxo.
O Google nao abriu numeros de latencia, custo por minuto ou limites de concorrencia, entao aqui vai inferencia plausivel de quem ja operou live API. Para manter conversa natural, o loop completo de escuta, resposta em audio e render de video precisa ficar abaixo de 800 milissegundos a 1,2 segundo na percepcao do usuario. Isso sugere inferencia em streaming, com geracao de video em baixa resolucao e upscale inteligente, mais buffer de expressoes para mascarar jitter de rede. O custo real nao vai estar no token de texto. Vai estar no minuto de video gerado e no uso paralelo de tools. Quem planejar atendimento em escala precisa modelar custo por sessao de 3 a 5 minutos, nao por mensagem.
Arquitetura que importa para voce
Pense como integracao enterprise. Voce conecta via API do Gemini Enterprise, define persona com look, voz e estilo, pluga tools via function calling assincrono e expõe em web, totem ou app. A parte de avatar customizado a partir de imagem de referencia preserva likeness e identidade da marca, o que e otimo para varejo, bancos e hotelaria, mas tambem cria fila de aprovacao e controle de uso. Todo output vem com SynthID, a marca d agua imperceptivel do Google em audio e video, para deteccao de conteudo gerado. Isso ajuda em compliance, mas nao resolve sozinho o risco de alguem filmar a tela e recortar.
O que isso muda na pratica
Quem ganha primeiro sao operacoes com roteiro visual repetitivo. Recepcao de hotel, onboarding de cliente, suporte com walkthrough passo a passo, treinamento interno, quiosque em loja. Um avatar que mostra e fala ao mesmo tempo reduz atrito de leitura e aumenta conclusao de tarefa, principalmente para publico menos tecnico. Para educacao e creators, o formato gera demos altamente compartilháveis porque junta novidade visual com interacao real. Nao e so uma thumb bonita, e uma conversa que voce pode testar.
Quem perde, pelo menos no curto prazo, sao stacks montadas com TTS mais avatar de terceiros costurados na mao. Muita empresa montou pipeline com um modelo de voz, outro de lip-sync e um player web para juntar tudo. Quando a plataforma entrega isso nativo, com sincronia multilingue e tool calling junto, aquele glue code vira divida tecnica. Se voce tem esse frankenstein rodando, comece a medir taxa de interrupcao, latencia percebida e custo de manutencao. A comparacao vai doer.
Acao pratica para esta semana: pegue um fluxo unico de 2 minutos, como confirmacao de agendamento ou troca de senha guiada, e rode em paralelo. De um lado seu bot de voz atual, do outro um prototipo com Live Avatar no Gemini Enterprise. Meca conclusao sem ajuda humana, tempo medio, repeticao de pergunta e custo por atendimento resolvido. Nao comece pelo avatar customizado da marca. Use um preset neutro, valide fluxo e tools, depois invista em identidade visual. Avatar bonito com tool quebrada so piora a frustracao.
A tensao que ninguem quer comentar
Aqui entra minha duvida real. Isso escala ou so muda o gargalo de lugar. Video em tempo real e caro para gerar e pesado para servir. Em pico com centenas de sessoes simultaneas, quem garante estabilidade sem degradar expressao ou dessincronizar a boca em portugues com ruido de fundo. O Google promete transicao entre 97 idiomas sem perda de fidelidade, mas teste real e com sotaque, interrupcao e gente falando junto. E tem o vale da estranheza. Um rosto quase humano que erra uma informacao quebra confianca mais rapido que uma voz robotica assumida.
Tem ainda o lado de identidade. Customizar a partir de foto de referencia e permitir uso de likeness abre espaco para uso interno legitimo e para abuso fora da plataforma. SynthID ajuda na deteccao, porem deteccao nao e prevencao. Empresas vao precisar de politica clara de onde esse avatar pode aparecer, log de sessao e aviso explicito de que se trata de IA. Sem isso, o ganho de conversao vira risco juridico.
Conclusao direta
Live Avatar e a evolucao obvia do Live: voz virou rosto, e rosto com tool assincrona vira agente que resolve enquanto fala. Vale o piloto agora, com um caso de uso fechado e metrica de custo por resolucao. Sera que seu usuario quer ser olhado pela IA ou so quer resolver rapido e desligar.
Comentários
0 comentáriosNenhum comentário ainda. Seja o primeiro a comentar.