
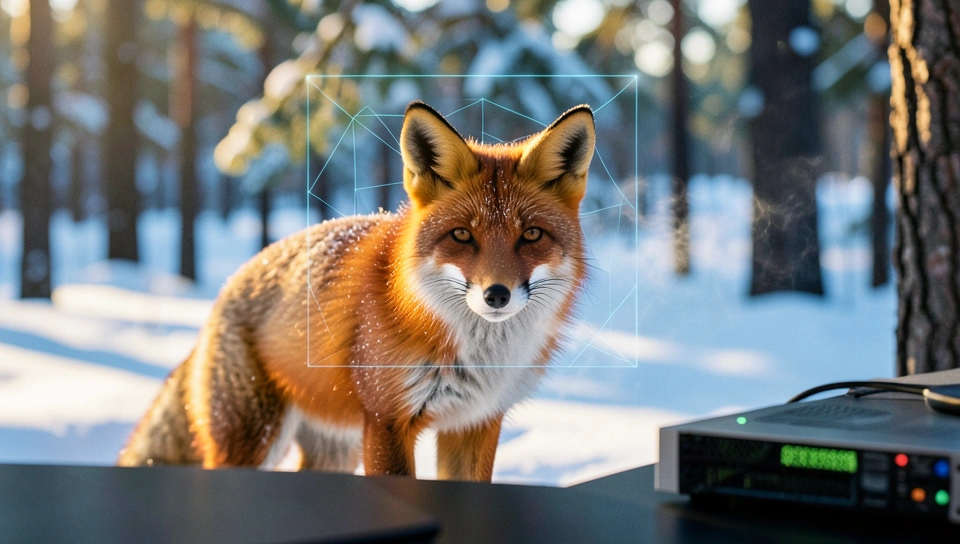
FLUX.3 Image Klein promete resolver o que mais trava imagem open-source
FLUX.3 Image Klein chegou ao Diffusers e já bagunçou meu backlog. Quem tenta rodar geração de imagem open-source em produção conhece bem o dilema: ou o modelo é bom e pesado demais, ou é rápido e ignora metade do prompt, ou até gera bonito mas não segura consistência entre uma imagem e outra. É sempre um trade-off entre qualidade, VRAM e latência que estoura o orçamento. A Black Forest Labs, que já domina esse jogo desde o FLUX original, agora tenta fechar essa conta com um modelo único que faz text-to-image, edição multi-referência e controle por layout, tudo no mesmo pipeline.
Testei a proposta na prática mental de operador: um checkpoint destilado que gera 1024 x 1024 em 16 passos, cerca de 2 segundos numa H100, com variantes quantizadas para GPUs menores e scripts de LoRA prontos. Parece bom demais para ser verdade, e é exatamente por isso que vale destrinchar. Não é só mais um lançamento com imagens bonitas no Space do Hugging Face. É uma mudança de arquitetura e de distribuição que afeta custo, integração e o jeito que a gente vai construir produto visual daqui para frente.
O fato
A Black Forest Labs liberou o FLUX.3 Image Klein, sua nova geração de modelo aberto de imagens, já integrado de forma nativa ao Diffusers. São dois checkpoints abertos reunidos na coleção FLUX.3 Image Klein, com um Space gratuito no Hugging Face para gerar na hora sem instalar nada. O foco não é só realismo, é versatilidade operacional. O mesmo modelo atende text-to-image puro, image-to-image com uma ou várias referências e controle de layout por bounding box.
Na prática do Diffusers, ele chega como um ModularPipeline. Você carrega com ModularPipeline.from_pretrained usando o repositório black-forest-labs/flux-3-image-klein, define dtype como bfloat16 e roda com pipe(prompt='a red fox', output='images'). A dependência nova é o transformers atualizado por causa do codificador de texto Qwen3-VL. Para GPUs menores, há pesos em NVFP4 e FP8 que carregam via from_single_file, além de scripts de LoRA tanto para text-to-image quanto para edição. É lançamento pensado para quem constrói, não só para quem gera wallpaper.
Como funciona na visão de operador
Em termos de API, a sacada é unificar três fluxos que antes pediam modelos ou adapters diferentes. No text-to-image, ele responde melhor a prompt descritivo completo, com sujeito, cenário, luz, composição e estilo. Nada de prompt de duas palavras. Pense em descrever a cena como um diretor de fotografia: uma raposa vermelha em clareira com neve, golden hour, sol baixo vindo da esquerda, sombras longas e azuis. O padrão do checkpoint destilado é 16 passos, e você ajusta altura, largura e num_inference_steps conforme a necessidade de detalhe versus velocidade.
Na edição, a lógica muda. Você passa a imagem de referência no argumento image e escreve o prompt como a legenda da imagem final, já com a mudança incluída. Quer transformar a raposa diurna em cena noturna, é só manter a descrição e trocar a luz para luar azul, sombras profundas e olhos refletindo. Com múltiplas referências, você passa uma lista como image=[red_fox, bench] e cita no prompt como menor que ref_image_0 maior que, menor que ref_image_1 maior que. Isso permite compor elementos, como a raposa da primeira imagem sentada no banco da segunda, mantendo identidade visual. Minha inferência técnica aqui, ainda sem profiling completo público, é que o cross-attention está muito mais amarrado ao encoder visual, o que explica a consistência melhor que nas versões anteriores.
Arquitetura e custo real
A arquitetura combina um transformer de difusão com o Qwen3-VL como encoder de texto, o que deve melhorar muito o entendimento de prompt longo e de relações espaciais. O formato modular do Diffusers permite remover blocos ou plugar os seus, o que é ouro para quem quer otimizar memória ou injetar ControlNet próprio, IP-Adapter ou lógica customizada. Sobre custo, o número oficial é 2 segundos para 1024 x 1024 numa H100 no checkpoint destilado. Isso coloca a inferência na casa de frações de centavo por imagem em cloud spot, mas numa A10 ou 4090 local a história muda. É aí que entram NVFP4 e FP8, que reduzem drasticamente a VRAM necessária, provavelmente para a faixa de 12 a 16 GB com offload, ao custo de uma pequena perda que na maioria dos casos de produto nem aparece.
O que isso muda na prática
Quem ganha primeiro é o dev indie e o estúdio pequeno. Antes você precisava de um modelo para gerar, outro para editar, mais um truque para manter personagem consistente e ainda um layout manual no Photoshop. Agora dá para prototipar tudo num pipeline só, versionável via Hugging Face e treinável com LoRA sem sair do ecossistema Diffusers. Quem perde, pelo menos no curto prazo, são wrappers pagos que cobravam caro só por consistência básica ou por upscale simples. Se o base open já segura multi-referência, o valor migra para workflow, dataset próprio e latência garantida.
Na operação, o ajuste imediato é de prompt e de pipeline. Pare de usar prompt curto e comece a padronizar templates com cena, luz e composição. Para controle de layout, o formato é uma lista JSON após a legenda, com id, bbox e desc, onde bbox usa escala de 0 a 1000 no formato y_min, x_min, y_max, x_max. Como é normalizado, o mesmo box funciona em qualquer resolução, o que simplifica muito gerar variações responsivas para feed, story e banner a partir do mesmo briefing.
- Ação prática para hoje: atualize com pip install -U diffusers transformers, baixe o checkpoint destilado e rode um teste A/B com seus prompts reais em 16 e 28 passos para medir ganho visual versus latência na sua GPU.
- Segunda ação: separe 20 a 50 imagens do seu produto ou personagem e rode o script de LoRA de edição, não só de geração, porque consistência de edição é o que vai segurar retenção em produto real.
- Terceira ação: teste o modo NVFP4 antes de comprar GPU nova, muita gente vai descobrir que já roda bem o suficiente para homologação.
A tensão que ninguém quer admitir
Aqui vai minha dúvida real de operador: isso escala ou só move o gargalo de lugar. Unificar tudo num modelo só é ótimo para teste, mas em produção com fila alta, 2 segundos numa H100 não significa 2 segundos para todo mundo. O Qwen3-VL é pesado, o pipeline modular adiciona overhead de orquestração e a quantização NVFP4 ainda depende de kernels específicos que nem todo provedor oferece com estabilidade. Você economiza em complexidade de código, mas pode pagar em debugging de memória e em latência de cauda quando mistura text-to-image e multi-referência no mesmo worker.
Tem outro ponto: controle por bounding box funciona bem em demo com fundo chapado e silhueta simples, mas quero ver segurar layout complexo com oclusão, texto pequeno e múltiplos objetos interagindo. Minha aposta é que para e-commerce, games e marketing de performance isso já resolve 80 por cento, mas para editorial fino ainda vai precisar de inpainting manual. O custo compensa se você tem volume e sabe fazer batch e cache de text encoder. Se gera poucas imagens esporádicas, talvez o Space gratuito ou uma API serverless continue mais barato que manter GPU ligada.
Conclusão prática
FLUX.3 Image Klein não é só mais qualidade, é menos fricção para colocar imagem open-source em produto real. Vale testar agora o destilado com seus dados e medir VRAM e latência na sua infra antes de assumir que precisa de GPU maior. Será que finalmente dá para aposentar aquele Frankenstein de três modelos emendados.
Comentários
0 comentáriosNenhum comentário ainda. Seja o primeiro a comentar.