
O travamento que mata qualquer robô útil
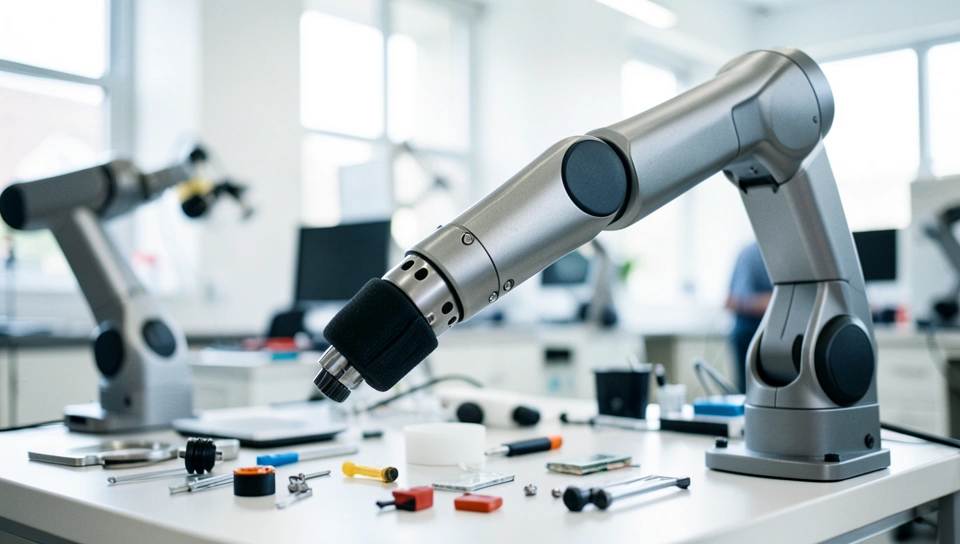
FLUX 3 Action chega para atacar o problema mais irritante de quem coloca IA em robô de verdade: o modelo enxerga bem, raciocina bem, mas age tarde demais. Quem já testou um VLM grande para controlar um braço robótico conhece o roteiro. Ele descreve a cena com perfeição, entende o comando em linguagem natural, e então leva segundos para cuspir o próximo movimento. Nesse intervalo a peça escorregou, a iluminação mudou ou alguém passou na frente da câmera. A Black Forest Labs, famosa pelos modelos de imagem FLUX, agora tenta resolver esse intervalo entre ver e agir com um modelo aberto focado em ação física contínua.
Se você constrói com robótica, essa é a métrica que importa. Não é só taxa de acerto em benchmark, é acerto por segundo, com hardware que cabe no orçamento e na bancada. Modelo que precisa de cluster na nuvem para dobrar um pano não serve para fábrica, logística ou laboratório. É nesse ponto que a proposta de um modelo mundo-ação com 7 bilhões de parâmetros, rápido e aberto, chama atenção. Menor, mais veloz e ainda assim com recorde de sucesso. Parece bom demais, e por isso vale dissecar com calma de operador.
O fato sem enfeite
A Black Forest Labs lançou o FLUX 3 Action, um modelo aberto para robótica construído sobre o FLUX 3 multimodal. O modelo base foi treinado principalmente em vídeo, com complemento de imagem e áudio, e agora ganha uma cabeça de ação. Na prática, ele recebe feeds de vídeo de múltiplas câmeras do espaço de trabalho do robô e prevê duas coisas ao mesmo tempo: qual deve ser a próxima ação do agente e como o ambiente deve mudar em resposta a essa ação. É a lógica de world model aplicada a controle, não só prever o futuro para assistir, mas prever para agir.
Segundo a empresa, o modelo atinge recorde de taxa de sucesso no leaderboard RoboLab-120 com apenas 7 bilhões de parâmetros. Isso seria menos da metade do tamanho do melhor modelo aberto anterior, rodando até 3,95 vezes mais rápido. Os pesos já estão disponíveis no Hugging Face. A empresa também sugere uso além da robótica física, com videogames como campo de teste para navegação e, no futuro, agentes que operam computadores com reação rápida. Direto ao ponto: é open source, é pequeno para os padrões atuais e foi desenhado para inferência perto do robô.
Como funciona na visão de quem opera
Pense no FLUX 3 Action como um loop percepção-predição-controle rodando em alta frequência. A entrada não é uma imagem isolada, são streams sincronizados de várias câmeras mais a instrução da tarefa. O modelo codifica essa percepção multimodal em uma representação de estado e, a partir dela, gera um comando de ação de baixo nível, como vetor de deslocamento do efetuador, abertura da garra ou velocidade das juntas, junto com uma previsão do próximo frame ou estado. Essa dupla saída é importante porque força consistência física. Ele não chuta um movimento aleatório, ele precisa imaginar o efeito daquele movimento na cena.
Em termos de arquitetura, dá para inferir um desenho plausível sem ter todos os detalhes do paper. Provavelmente um backbone transformer de vídeo eficiente, com compressão temporal agressiva e cabeças separadas para política e dinâmica. O ganho de 3,95 vezes em velocidade sugere otimização forte em atenção, cache de contexto curto e destilação do FLUX 3 maior. Sete bilhões ainda não é leve para embarcado puro, mas já entra na faixa de uma GPU workstation ou de um módulo edge parrudo com quantização em 8 ou 4 bits. Com TensorRT ou vLLM bem ajustado e horizonte de ação curto, dá para mirar em dezenas de inferências por segundo, o que muda o jogo em tarefas de contato como pegar, inserir e empilhar.
O ponto dos videogames como teste também faz sentido técnico. Jogo é um simulador barato, com física imperfeita mas rápida, resets infinitos e telemetria perfeita. Se o modelo aprende a navegar, mirar e reagir em 60 quadros por segundo num ambiente sintético, ele exercita a mesma capacidade de prever ação e consequência que um braço precisa. Não significa transferência direta para o mundo real, mas ajuda a validar latência, estabilidade temporal e generalização de política antes de queimar hardware caro.
O que isso muda na prática
Para quem está construindo, o recado é claro. Modelos raciocinadores gigantes continuam ótimos como planejadores de alto nível, aquele cérebro que quebra a tarefa em etapas. Só que eles não precisam mais tentar fazer tudo. Você pode separar em duas camadas: um modelo grande que pensa devagar a cada poucos segundos e um modelo ação como o FLUX 3 Action que executa rápido a 10 ou 20 Hz. Essa hierarquia já é padrão em laboratórios bons e agora fica mais acessível com pesos abertos. Quem perde espaço é a solução fechada e pesada que tentava vender percepção e controle num pacote só, caro e preso na nuvem.
- Teste real em uma semana: baixe os pesos no Hugging Face e rode em um braço simples com duas câmeras, uma tarefa de pick and place bem definida e medição de sucesso por tentativa mais latência média.
- Meça o que importa: taxa de sucesso, tempo por episódio, jitter de controle e falhas por oclusão ou mudança de luz, não só acerto em dataset gravado.
- Compare custo total: GPU local com quantização contra inferência remota, incluindo rede, fila e queda de conexão no chão de fábrica.
A ação prática mais valiosa agora é montar esse harness mínimo de avaliação. Não acredite no número do RoboLab-120 como garantia para o seu cenário. Grave 50 episódios no seu ambiente, com seus objetos, sua iluminação e sua câmera barata. Rode o modelo base zero-shot, depois com um ajuste fino leve. Se ele mantiver taxa decente com latência abaixo de 100 ms por passo, você tem uma base para iterar. Se oscilar muito com pequena mudança de câmera, você descobriu cedo que precisa de mais calibração ou de dados próprios.
Mas isso escala de verdade
Aqui entra a dúvida que importa. Sete bilhões de parâmetros e quase 4 vezes mais rápido é ótimo no papel, mas robótica morre em detalhe físico. Generalização entre câmeras, atrito, deformação, reflexo e oclusão ainda derruba modelo bom. Um recorde em 120 tarefas de laboratório não garante robustez em corredor de depósito com poeira e empilhadeira passando. E tem o custo escondido: coletar dados de demonstração, sincronizar multicâmera, calibrar ação e manter o loop em tempo real dá trabalho pesado de engenharia que nenhum peso aberto resolve sozinho.
Outro ponto é a promessa multimodal com vídeo, imagem e áudio. Treinar em vídeo ajuda a entender dinâmica, mas vídeo da internet não tem força, torque ou propriocepção. O modelo aprende como as coisas parecem se mover, não necessariamente como é mover com um corpo específico. Isso move o gargalo em vez de eliminar. Antes o gargalo era raciocínio lento, agora pode virar adaptação ao seu robô, ao seu gripper, ao seu controle de baixo nível. Aberto ajuda porque permite ajuste fino, mas exige time que saiba fazer esse ajuste sem quebrar o que já funciona.
Conclusão prática
No fim, o FLUX 3 Action é o tipo de lançamento que vale testar em vez de só comentar. Ele troca um pouco de cérebro gigante por corpo rápido e aberto. Será que velocidade com 7B sustenta precisão em contato real fora do benchmark?
Comentários
0 comentáriosNenhum comentário ainda. Seja o primeiro a comentar.