
O problema nunca foi fazer o robô andar
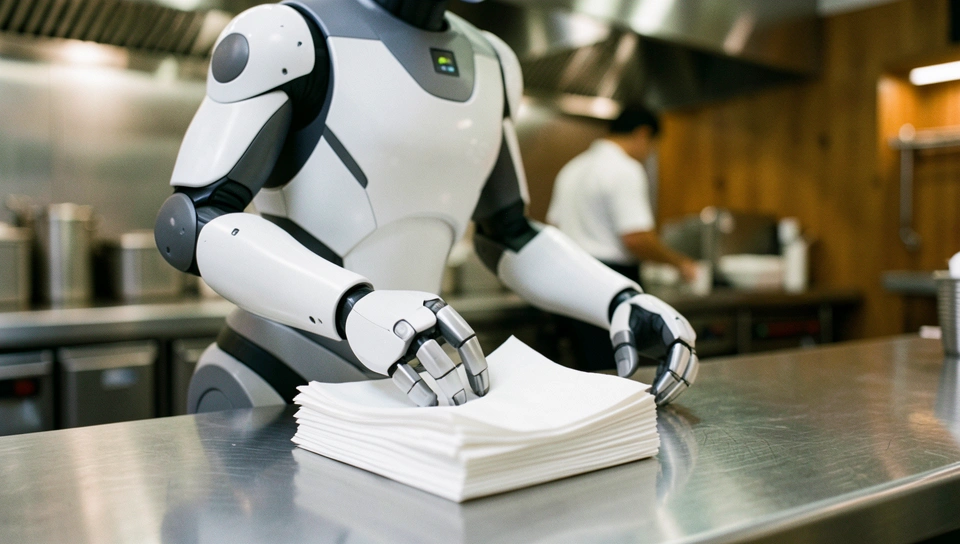
Dyna-2 apareceu exatamente onde a robótica sempre trava: não no vídeo bonito de 30 segundos, mas na hora 47 de uma tarefa chata, repetitiva e mal paga. Dobrar guardanapo em restaurante, arrumar quarto de hotel, repetir o mesmo movimento milhares de vezes sem quebrar, sem travar e sem precisar de um engenheiro do lado. A Dyna Robotics diz que chegou a 99,4% de sucesso dobrando guardanapos por 24 horas seguidas, inclusive se recuperando depois de derrubar a pilha inteira. Se isso for verdade fora do laboratório, a conversa muda de modelo para operação.
O ponto aqui não é o humanóide. É a autonomia de longa duração. Agente de software que roda por uma hora já dá trabalho para manter estável. Agente físico que roda por uma hora, com atrito, oclusão, gente passando na frente e objeto deformável na mão, é outro nível de dificuldade. É isso que a Dyna está tentando provar com o Taku, seu semi-humanóide com rodas, e com o Dyna-2.1 rodando em clientes reais como Din Tai Fung.
O fato
A Dyna anunciou o Dyna-2 como um modelo mundo-ação pré-treinado com mais de um milhão de horas de vídeo humano. A ideia central é simples de enunciar e brutal de executar: em vez de treinar só mapeando imagem para ação, o modelo aprende a prever o futuro em vídeo e usa essa previsão para guiar a ação do robô. Depois do pré-treino massivo, ele é adaptado para um corpo específico com pouquíssima demonstração, algo na casa de 45 minutos para tarefas novas.
Na sequência veio a parte que importa para quem opera: o deployment. Robôs Taku já estariam dobrando milhares de guardanapos por dia em operação real, além de pilotos em hotelaria. O cofundador e cientista-chefe Jason Ma apresentou o sistema como um agente físico generalista, com harness agêntico para executar workflows de dezenas de minutos até uma hora, com recuperação de falha embutida. Não é mais um teleoperado disfarçado. A proposta é autonomia supervisionada de longa duração.
Como funciona, na visão de quem opera
Pensa no Dyna-2 como dois cérebros colados. Um prevê: dado o estado atual, como o mundo deve ficar nos próximos segundos. O outro age: qual sequência de torques e posições leva a esse futuro. Essa arquitetura de world-action model tenta resolver o calcanhar de Aquiles dos VLAs puros, que costumam ser reativos demais e sofrem com contato físico, deformação e atraso. Prever vídeo futuro funciona como um prior físico aprendido de YouTube e de câmera egocêntrica em escala absurda.
Por baixo, o time fala em diffusion transformers com flow matching para gerar trajetórias. Faz sentido para controle. Difusão gera distribuições multimodais de movimento, o que é ótimo quando há vários jeitos de pegar o mesmo guardanapo, e o flow matching ajuda a amostrar mais rápido, com menos passos. Para rodar em tempo real, provavelmente há destilação agressiva para um policy menor on-device, com o modelo gigante ficando no treino e no replanejamento de alto nível. Latência aqui é vida ou morte. Se o loop de controle passar de 100 a 200 milissegundos, mão destrambelha e objeto escorrega.
O outro truque é transferência humano-robô. Um milhão de horas de vídeo humano não ensina torque, mas ensina affordance, sequência e física intuitiva: onde segurar, como dobrar, o que acontece se puxar forte demais. Depois, com 45 minutos de demonstração no robô específico, o modelo ancora esse prior no corpo real. É plausível que funcione bem para manipulação quase estática, como dobrar e empilhar, e muito pior para contato dinâmico rápido. A Dyna teria ainda leis de escala mostrando ganho consistente ao aumentar dados humanos em quatro ordens de magnitude, o que, se se confirmar, é o Bitter Lesson aplicado à robótica: menos engenharia de caso, mais dados.
Por que hardware próprio e com rodas
A Dyna optou por não usar humanóide bípede pronto. Construiu um semi-humanóide com base móvel sobre rodas. Para quem já operou robô em loja ou cozinha, a decisão é óbvia. Bípede cai, consome bateria, vibra e complica o controle. Rodas dão estabilidade, simplificam navegação e barateiam a plataforma para escalar. O gargalo continua nas mãos. Mão destra ainda esquenta, desgasta cabo, perde tato e custa caro. E sem tato, visão sozinha não resolve. O modelo pode prever bem o vídeo, mas não sente escorregamento de tecido de 2 milímetros. É aí que entram sensores de força, compliance e o harness que detecta falha e tenta de novo.
O que isso muda na prática
Quem ganha primeiro não é a fábrica escura do futuro. É o restaurante, o hotel e a cozinha industrial com tarefa repetitiva, ambiente semi-estruturado e turnover alto. Dobrar guardanapo parece bobo, mas tem as três propriedades que viabilizam robótica hoje: alta repetição, baixa variabilidade de objeto e tolerância a erro pequeno. Se o robô faz isso por uma hora sem intervenção, o custo por tarefa começa a fechar contra mão de obra noturna.
- Quem constrói automação: precisa parar de pensar em skill isolada e passar a pensar em workflow com recuperação. O diferencial não é pegar, é continuar depois de errar.
- Quem opera loja ou restaurante: ganha um piloto que pode virar escala, mas precisa instrumentar tudo: taxa de intervenção, tempo médio entre falhas, tempo de recovery e custo por mil unidades.
- Quem pesquisa VLA: precisa testar world model de verdade. Prever futuro ajuda em manipulação deformável onde política reativa oscila.
A ação prática desta semana é direta. Se você avalia robô para operação, exija o teste das 24 horas. Não aceite vídeo editado. Peça log contínuo com três métricas: taxa de sucesso por ciclo, número de intervenções humanas por hora e comportamento pós-falha. No caso da Dyna, o exemplo de derrubar a pilha e continuar é mais importante que os 99,4%. Recuperação é o que separa piloto de produção. Monte também um kit de 45 minutos: filme sua tarefa de três ângulos, padronize o posto de trabalho e meça quanto tempo até o robô ficar minimamente útil. Se passar de um turno para adaptar, o custo de integração mata o ROI.
A tensão que ninguém quer admitir
Aqui vai a dúvida real de operador: um milhão de horas de vídeo humano resolve ou só move o gargalo para outro lugar. Minha leitura é que resolve percepção e sequência, mas empurra o problema para física de contato e hardware. Vídeo não tem força, não tem peso, não tem escorregamento. Você pode escalar mais uma ordem de magnitude e ainda ficar preso na mão que superaquece e no sensor tátil que não existe em escala. A Dyna tenta contornar com dados sintéticos e auto-geração, com o próprio modelo gerando simulação para treinar a próxima versão. Funciona até certo ponto, depois o sim-to-real cobra a conta em atrito e deformação.
Tem também a conta de inferência. Modelo gigante que prevê vídeo futuro não roda liso no edge sem destilação pesada. Cada destilação tira um pouco de generalização. Cada customização de hardware prende você no próprio stack. A Dyna verticalizou tudo, do modelo ao Taku, para controlar latência e supply chain. Isso acelera agora e pode virar peso depois, porque escalar milhões de robôs com hardware próprio é guerra logística, não guerra de paper. Custo, assistência técnica e peça de reposição decidem mais que benchmark.
Conclusão
Dyna-2 é o sinal mais forte até agora de que robótica generalista pode sair do demo para o turno completo, desde que o recorte seja tarefa longa, chata e repetível. O modelo mundo-ação com pré-treino massivo mais adaptação rápida é um caminho crível, mas o teste final não é lei de escala. É uma semana inteira sem engenheiro babá. Será que sua operação aguentaria uma hora de autonomia real sem intervenção.
Comentários
0 comentáriosNenhum comentário ainda. Seja o primeiro a comentar.