
O gargalo não é o laudo, é a fila
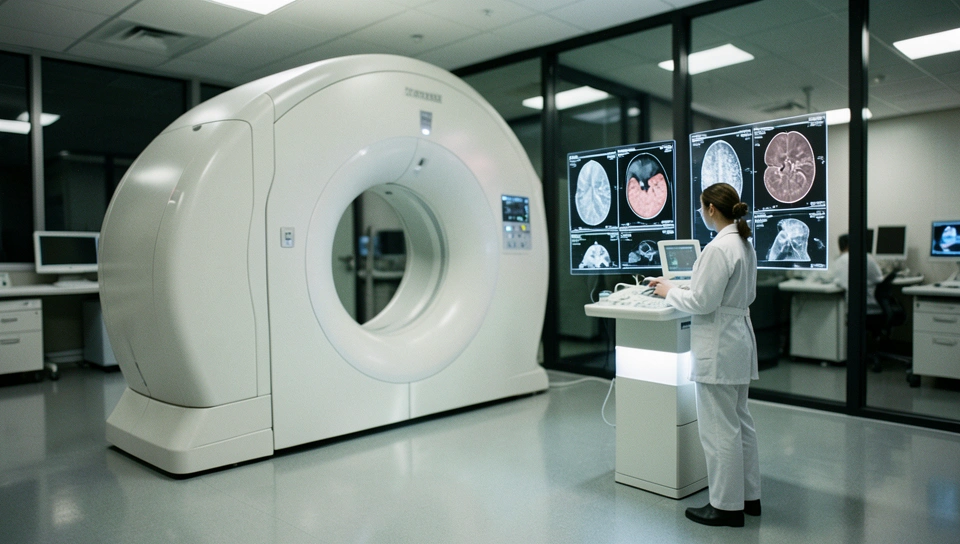
Damo Radar chegou em um momento em que a radiologia já opera no limite. Quem já esperou semanas por um laudo de tomografia sabe que o problema não é só precisão, é vazão. Faltam radiologistas, sobram exames e o abdômen é um dos piores gargalos porque uma única TC com contraste pode esconder dezenas de achados em fígado, pâncreas, rins, intestino e vasos. É nesse contexto que o modelo open-source da Damo Academy, braço de pesquisa do Alibaba, promete virar o jogo ao ler TCs abdominais e sinalizar 146 condições diferentes, incluindo tumores malignos, com desempenho que teria superado a maioria dos radiologistas em quase 40 mil exames reais. Para quem opera clínica, hospital ou healthtech, a pergunta imediata não é se a demonstração impressiona, e sim se dá para colocar isso no fluxo sem quebrar compliance, custo e latência.
O que a Alibaba liberou de verdade
O fato é direto. A Damo Academy abriu o Damo Radar, um modelo de visão e linguagem treinado para analisar tomografias computadorizadas com contraste focadas no abdômen. Ele cobre 18 órgãos e foi desenhado para atuar como um generalista, não como um detector único de nódulo de pulmão ou câncer de fígado. Na avaliação descrita em estudo publicado na Science, o modelo foi testado em quase 40 mil exames de mundo real e atingiu AUC médio de 0,913 em 146 achados clínicos. AUC é uma métrica que vai de 0,5 a 1,0, onde 1,0 seria acerto perfeito, então 0,913 é um número forte para uma tarefa tão ampla. O time afirma que é o primeiro modelo generalista de imagem médica em nível de especialista, e que a abordagem de treino poderia ser estendida para outros tipos de imagem no futuro.
O ponto que muda tudo para quem constrói é o open-source. Não estamos falando de mais um anúncio de API fechada com demo bonita. O peso aberto permite baixar, auditar, fazer fine-tuning com dados locais e embutir em um pipeline próprio de triagem ou segunda leitura. Isso reduz dependência de fornecedor estrangeiro fechado e abre espaço para adaptação à população brasileira, aos protocolos de contraste usados aqui e aos aparelhos instalados no parque nacional, que variam muito em resolução e dose. Ainda assim, aberto não significa plug and play. Modelo médico exige validação local, calibração de threshold por achado e um desenho claro de responsabilidade sobre quem assina o laudo final.
Como funciona na visão de quem opera
Pensando como operador, o Damo Radar segue a lógica dos modelos de visão e linguagem que dominaram a IA nos últimos dois anos, só que aplicada à TC. De um lado, um encoder visual que fatia o volume 3D da tomografia e aprende representações de textura, forma e realce por contraste. Do outro, um encoder de texto alinhado aos laudos clínicos reais. Durante o treino, o modelo aprende a aproximar a imagem da descrição correta do laudo e a afastar das descrições erradas. Na inferência, ele recebe o volume da TC com contraste e gera probabilidades para cada um dos 146 achados, além de atenção espacial que indica onde ele está olhando em cada órgão. É plausível que a arquitetura use transformers 3D para o volume e um backbone de linguagem médica para ancorar os conceitos, com cabeças multi-tarefa separadas por órgão para evitar que um sinal forte no fígado mascare um sinal sutil no pâncreas.
O que não foi detalhado publicamente, e aqui entra inferência técnica, é custo e latência. Uma TC abdominal com contraste tem centenas de cortes e facilmente passa de 200 a 500 MB em DICOM. Rodar um modelo generalista 3D desse porte não é inferência leve de raio-X. Em uma estimativa plausível, estamos falando de alguns segundos a dezenas de segundos por exame em uma GPU classe A100 ou H100, com consumo de memória alto por causa do volume 3D e das 146 cabeças de classificação. Para uma clínica que processa 200 TCs por dia, isso significa pensar em batch assíncrono, fila com autoescalonamento e cache de pré-processamento para normalização de espaçamento, janela de Hounsfield e fase de contraste. O custo por exame pode ficar baixo se bem otimizado, na casa de centavos de dólar em nuvem spot, mas dispara se você tentar rodar em tempo real para cada corte sem otimização com quantização, TensorRT ou vLLM adaptado para visão.
Onde ele se encaixa na arquitetura do PACS
Na prática, ninguém vai trocar o PACS por um modelo. O desenho que faz sentido é um microsserviço ao lado do PACS e do RIS. O exame cai no PACS, um listener dispara um job, o serviço anonimiza, converte DICOM para NIfTI, normaliza, roda o Damo Radar e devolve um JSON estruturado com probabilidades por achado e mapas de atenção. Esse JSON alimenta três frentes: fila de priorização para casos suspeitos de tumor ou abdome agudo, pré-preenchimento do laudo estruturado para o radiologista revisar, e dashboard de qualidade para auditoria. Latência aceitável aqui é de um a três minutos por exame em background, não milissegundos. O ganho não vem de responder mais rápido no chat, vem de ordenar a fila pelo risco e de reduzir o tempo que o radiologista gasta caçando achados secundários que muitas vezes passam batido quando o achado principal já consome toda a atenção.
O que isso muda na prática
Quem ganha primeiro são operações com volume alto e equipe enxuta. Pronto-socorros, centros de diagnóstico por imagem no interior e telerradiologia. Para esses perfis, um generalista com AUC médio de 0,913 funciona como uma segunda leitura incansável que nunca deixa de checar os 18 órgãos por cansaço no fim do plantão. Também ganha quem desenvolve software para radiologia no Brasil, porque agora existe uma base aberta forte para fazer fine-tuning com dados locais e criar um produto adaptado à ANVISA e à LGPD sem começar do zero. Quem perde, pelo menos no discurso fácil, seriam os fornecedores de detectores pontuais, aqueles que vendem uma IA só para um órgão. Quando um modelo aberto cobre 146 achados de uma vez, fica difícil justificar pagar cinco licenças separadas com cinco integrações diferentes.
A ação prática para esta semana é simples e barata. Monte um piloto de triagem retrospectiva antes de pensar em tempo real. Separe 500 a 1.000 TCs abdominais já laudadas da sua operação, com diversidade de aparelhos e protocolos, anonimize tudo e rode o Damo Radar em ambiente isolado. Meça sensibilidade e especificidade por grupo de achado relevante para você, como massas hepáticas, lesões pancreáticas, dilatação de vias biliares e obstrução intestinal, e compare com o laudo original mais a revisão de um radiologista sênior nos casos discordantes. Defina thresholds diferentes por achado em vez de um corte único, porque um falso positivo para um cisto simples tem custo operacional totalmente diferente de um falso negativo para tumor de pâncreas. Esse teste revela em duas semanas se o modelo transfere bem para o seu parque de equipamentos ou se vai exigir fine-tuning local.
- Priorize fila por risco: use o score de tumor e achados agudos para ordenar a leitura, não para laudar sozinho.
- Pré-preencha laudo estruturado: deixe o radiologista apenas confirmar, corrigir e assinar, mantendo responsabilidade humana.
- Registre tudo: guarde versão do modelo, threshold usado e tempo de inferência por exame para auditoria futura.
A dúvida que ninguém quer fazer
Aqui está a tensão real. AUC médio de 0,913 em 40 mil exames é impressionante, mas média esconde cauda longa. Em medicina, o que quebra operação não é o acerto nos 20 achados comuns, é o erro nos 30 achados raros e nos casos atípicos com contraste ruim, artefato de movimento ou paciente com anatomia pós-cirúrgica. O estudo mostra superioridade sobre a maioria dos radiologistas naquele dataset, mas dataset de pesquisa raramente reflete a bagunça de um pronto-socorro brasileiro numa sexta à noite, com protocolo quebrado e TC feita em aparelho antigo. Generalista resolve parte do problema da fragmentação, mas cria um problema novo e mais sutil que é a calibração. Um modelo que marca 146 coisas ao mesmo tempo tende a gerar mais alertas, e alerta demais vira fadiga de alerta. Se o radiologista passar a ignorar o sistema porque ele apita para todo cisto renal irrelevante, o ganho de segurança evapora.
Tem ainda a conta que ninguém posta no anúncio. Open-source zera o custo de licença, mas transfere o custo para infraestrutura, validação clínica, monitoramento de drift e responsabilidade regulatória. Quem opera no Brasil vai precisar validar para ANVISA se quiser usar como apoio à decisão, manter trilha LGPD para dados sensíveis, e monitorar queda de performance quando trocar o tomógrafo ou atualizar protocolo de contraste. Isso escala tecnicamente, porque GPU e fila resolvem, mas escala operacionalmente só se houver um dono claro do pipeline que recalibre thresholds a cada trimestre e investigue discordâncias. Caso contrário, o projeto vira mais um piloto bonito que nunca entra em produção porque ninguém quer assinar o risco.
Conclusão que importa para quem opera
Damo Radar é o sinal mais forte até agora de que a imagem médica caminha para modelos generalistas abertos, não para dezenas de detectores fechados. Vale testar agora em modo sombra, medir na sua casuística e usar para priorizar fila. Mas a pergunta que fica é dura e prática: na sua operação, quem vai calibrar, monitorar e responder quando o modelo errar um câncer sutil que o radiologista cansado também deixaria passar.
Comentários
0 comentáriosNenhum comentário ainda. Seja o primeiro a comentar.