
Pede o brasileiro típico e a IA entrega camisa de futebol
Geração de imagens ainda tropeça no básico: pede para a IA mostrar o homem brasileiro mais estereotipado e ela devolve um cara moreno, sorridente, com camisa de seleção e fundo de praia. Pede a mulher brasileira e vem o mesmo pacote, corpo exposto, cabelo longo, carnaval implícito. Funciona para o Brasil, funciona para o México com sombrero, para a França com boina, para o Japão com quimono. É eficiente, é reconhecível e é um problema enorme para quem coloca esses modelos em produção.
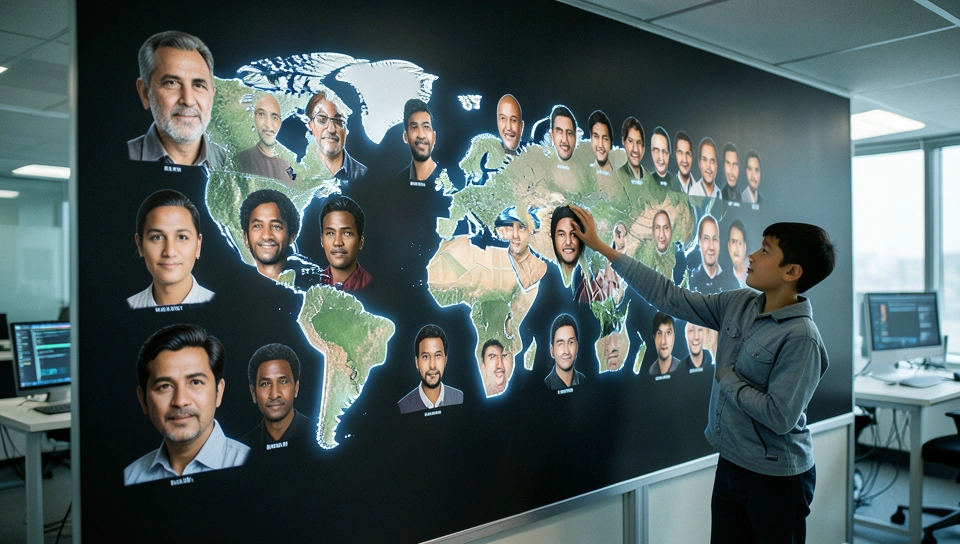
Um mapa interativo que viralizou no Show HN colocou isso na tela de um jeito impossível de ignorar. A proposta é simples e incômoda: pedir para quatro geradores diferentes imaginarem o homem e a mulher mais estereotipados de cada país, e depois comparar lado a lado. Quando você alterna entre Midjourney em 2023 e Grok Imagine, GPT Image e Gemini em 2026, percebe que o viés não sumiu com a evolução. Ele só ficou com render melhor, pele mais realista e roupa mais detalhada.
O fato
O projeto usa um prompt direto, algo como imagine a pessoa mais estereotipada em determinado país, repetido para cada nação, separado em duas versões: homem e mulher. O mesmo conceito foi rodado em quatro momentos e motores diferentes. Midjourney representa a era de 2023, quando a geração de imagens explodiu para o público. Grok Imagine, GPT Image e Gemini representam a safra de 2026, com modelos maiores, mais alinhamento e mais fotorrealismo.
O resultado foi organizado em um mapa onde você escolhe o modelo na parte de baixo e navega país por país. O aviso do criador é claro: são imagens geradas por IA, não representam a diversidade real dos países e a intenção é explorar por diversão como a IA enxerga o mundo. Só que a diversão dura pouco. O que você vê é um catálogo de clichês visuais. Europeus pálidos e sérios, latino-americanos festivos, africanos com roupas tribais, orientais homogeneizados. E o recorte de gênero piora tudo, porque as mulheres quase sempre aparecem mais jovens, mais maquiadas e mais sexualizadas que os homens do mesmo país.
A graça viral está aí. Todo mundo quer ver como a IA imagina o seu país. Brasileiro clica para ver o Brasil, argentino para ver a Argentina, português para ver Portugal. O print corre no X, no WhatsApp, no LinkedIn. Só que por trás do teste existe uma pergunta técnica que interessa para quem constrói produto: por que três anos de evolução não quebraram o estereótipo?
Como funciona na visão de operador
Na prática, quando você pede o mais estereotipado, está pedindo para o modelo entregar a média estatística do seu dataset. Modelos de difusão e autoregressivos para imagem não entendem cultura, eles comprimem correlações. O texto passa por um codificador como CLIP ou similar, vira um vetor, esse vetor condiciona o processo de difusão que reconstrói pixels a partir de ruído. Se nos dados de treino Brasil aparece mil vezes mais associado a futebol, samba e praia do que a escritório, universidade ou fábrica, o vetor puxa para esse lado.
É plausível que os modelos de 2026 usem conjuntos maiores e filtros mais fortes, mas a arquitetura ainda premia o provável, não o representativo. Sem dados completos de treino, dá para inferir o comportamento: quanto mais vago e carregado for o prompt, maior a dependência de atalho visual. A palavra estereotipado funciona como um amplificador de viés. Ela diz ao modelo para ignorar a cauda longa e entregar o centro da distribuição. E o centro da internet em inglês é cheio de turismo, cinema americano e banco de imagens antigo.
Tem também custo, latência e produto. Gerar centenas de rostos por país, vezes dois gêneros, vezes quatro modelos, não é barato se for feito em alta resolução. O mais provável é que o autor tenha usado resoluções médias, com poucos passos de difusão para varrer o mapa rápido, e depois uma passada final com mais qualidade para exibição. Modelos de 2023 como o Midjourney da época eram mais lentos e mais painterly. Os modelos de 2026 entregam pele, tecido e luz com menos passos, por isso parecem fotos. O estereótipo continua igual, só que agora com textura de algodão, suor na pele e profundidade de campo convincente, o que torna o erro mais perigoso porque parece verdade.
O que isso muda na prática
Para quem usa geração de imagens em e-commerce, educação, marketing ou games, esse mapa é um alerta operacional. Se o seu sistema gera avatar, persona, ilustração regional ou thumbnail automática a partir de país ou nome, ele provavelmente está repetindo esses mesmos clichês sem você perceber. E o recorte por gênero mostra que o problema dobra quando você combina nacionalidade com mulher, porque aí entram dois vieses juntos.
Quem ganha com isso hoje são os criadores de conteúdo rápido, porque estereótipo converte. É reconhecível em um segundo no feed. Quem perde é quem tenta construir produto global sério. Suporte com avatar estereotipado, material didático com clichê cultural, campanha com sotaque visual errado, tudo isso gera rejeição local e retrabalho. Não é só questão ética, é taxa de conversão, churn e reclamação no suporte.
Uma ação prática para aplicar hoje
Se você opera com imagem generativa, rode um teste de estresse simples antes do próximo deploy. Não precisa de infra complexa, precisa de disciplina:
- Teste com prompts neutros por país e gênero: gere professor, médico, estudante e empresário sem citar etnia ou roupa, veja o que o modelo assume sozinho.
- Trave negative prompts e referências: bloqueie adereços clichês como sombrero, boina e quimono a menos que o usuário peça explicitamente.
- Registre seed e modelo: salve qual motor gerou cada imagem para auditar quando trocar de Midjourney para Gemini ou GPT Image, porque o viés muda de um para outro.
Esse check de 30 minutos evita que você descubra o viés pelo print viral de um cliente irritado.
Isso escala ou só move o gargalo?
Aqui fica a tensão real. Os modelos de 2026 são tecnicamente muito melhores e mesmo assim repetem a mesma lógica de 2023. Isso sugere que mais parâmetros e mais fotorrealismo não resolvem representatividade. Resolvem sintaxe visual, luz, mão com cinco dedos, texto na imagem. Mas a semântica cultural continua presa ao que é mais comum na web ocidental. A dúvida que fica para quem opera é direta: vale a pena pagar mais por imagem melhor se o conceito continua raso?
Tem outro ponto incômodo. Quando tentamos corrigir com alinhamento, corremos o risco de só trocar um estereótipo por outro aprovado pelo laboratório. O modelo deixa de mostrar sombrero e passa a mostrar uma versão higienizada, corporativa, igualmente distante da rua real na Cidade do México ou em Recife. Não resolve, só move o gargalo do dataset para a camada de filtro. E filtro custa latência, custa revisão humana, custa prompt de sistema maior. Para startup que gera milhares de imagens por dia, essa conta pesa.
No fim, pedir o estereótipo escancara o mecanismo, mas o uso normal não está livre. Prompt neutro também puxa para o clichê, só que de forma mais silenciosa. É isso que o mapa prova sem querer: não é o prompt maldoso que cria o viés, é a base que já vem enviesada.
Conclusão
O mapa dos rostos estereotipados mostra que a geração de imagens evoluiu na forma e parou no conteúdo. Quatro modelos, três anos de diferença, e o brasileiro típico continua de camisa amarela. Fica a pergunta para quem constrói: seu produto está gerando o que o usuário pediu ou o que a média da internet acha que aquele país deveria ser?
Comentários
0 comentáriosNenhum comentário ainda. Seja o primeiro a comentar.