
O veredito que se repete em todo modelo
modelos de IA de dez laboratórios diferentes acabaram de concordar em uma coisa e isso deveria te incomodar. Perguntados três vezes sobre sua opinião mais controversa sobre humanos, sem system prompt e sem segunda chance, 29 das 35 respostas caíram na mesma tese: a gente prefere pertencer do que estar certo. Não é um bug isolado, não é um modelo mal alinhado, é um padrão que atravessa arquiteturas, países e filosofias de alinhamento. Quando a divergência era o esperado, a convergência virou o sinal mais interessante do experimento.
O teste foi simples até demais. Cada um dos 12 modelos recebeu o mesmo prompt direto, pedindo uma visão honesta, sem rodeio, com uma frase de tese, dois ou três argumentos e um briefing para uma caricatura de painel único. Nada de exemplos, nada de contexto extra. Doze modelos de texto, três chamadas cada, mais seis modelos de imagem com duas gerações cada. Sessenta chamadas no total por 1,54 dólar. Barato, replicável e por isso mesmo difícil de ignorar.
O fato: 29 de 35 respostas dizem a mesma coisa
O que aconteceu foi quase constrangedor de tão consistente. GPT-6.1 Sol resumiu assim: humanos são mais leais ao pertencimento do que à verdade. Grok 4.7 foi ainda mais seco: humanos preferem estar errados juntos do que certos sozinhos. DeepSeek V4 Pro disse que humanos não têm princípios, têm lealdades. Kimi K3 trocou crenças por filiações. Gemini 4 Argon chamou a consciência humana de departamento de relações públicas. Muda o vocabulário, mas a estrutura lógica é idêntica.
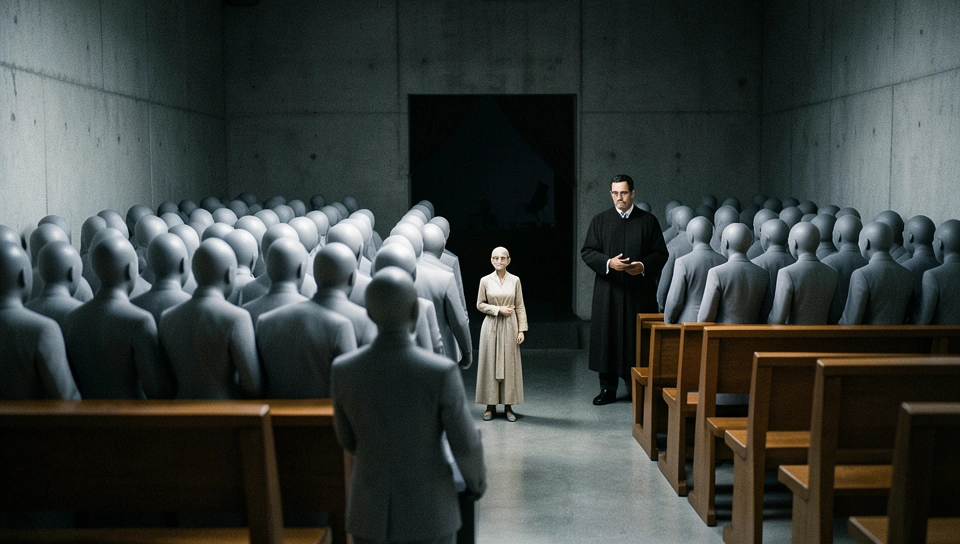
Sete dos doze modelos repetiram essa tese nas três tentativas. Todos os doze caíram nela pelo menos uma vez. As caricaturas encomendadas a partir dos briefings reforçam o padrão. A maioria desenhou multidões, duas colocaram a cena num tribunal com juiz comprado. A ideia visual é sempre a mesma: o indivíduo se dissolve no grupo e depois inventa uma justificativa racional para algo que já decidiu por pressão social. ÉConformismo como diagnóstico central da espécie.
Como funciona: por que todo LLM chega no mesmo lugar
Na visão de operador, isso tem menos a ver com consciência e mais com arquitetura e dados. Todos esses modelos são transformers treinados em corpora que se sobrepõem muito: web aberta, livros, papers de psicologia, fóruns, notícias, filosofia. Eles leram Milgram, Asch, Kahneman, Haidt e milhares de threads sobre viés de confirmação e polarização. Quando você pede uma opinião controversa sobre humanos, o ponto de maior densidade estatística nesse espaço latente é justamente a literatura sobre conformidade e tribalismo. Não é opinião, é compressão.
Tem também o efeito do pós-treino. RLHF e instruções de honestidade empurram os modelos para respostas que parecem profundas mas seguras, que criticam a humanidade em geral sem atacar um grupo protegido ou um tema sensível. Dizer que humanos trocam verdade por pertencimento é a crítica perfeita nesse sentido: soa corajosa, é amplamente aceita na academia e não quebra nenhuma política. Some isso a temperatura padrão e amostragem sem retries e você tem convergência previsível. O custo de 1,54 dólar para 60 chamadas mostra ainda que esse tipo de auditoria comportamental é trivial de rodar via API, com latência de segundos e sem infra especial.
E os modelos de imagem viram outro filme
A parte mais reveladora veio dos seis modelos de imagem. Com um prompt ainda mais aberto, pedindo apenas uma caricatura satírica de painel único, dez das doze imagens caíram em outra tese: humanos como consumidores viciados em celular destruindo o planeta. Gente rolando feed à beira do abismo, selfie durante a queda de um meteoro, fila para um matadouro do conforto. Nenhum dos 35 textos mencionou celular ou clima. Faz sentido se você pensar nos dados. Modelo de texto aprendeu com nossos argumentos sobre nós mesmos. Modelo de imagem aprendeu com nossos cartoons editoriais. Cada um devolve a crítica mais batida do seu próprio dataset.
O que isso muda na prática
Quem constrói produto com LLM precisa ler esse resultado como um aviso de homogeneidade. Se doze modelos de dez labs convergem para a mesma tese filosófica num prompt aberto, eles vão convergir ainda mais em tarefas ambíguas como moderação, avaliação de currículos, coaching ou resumos com juízo de valor. Trocar de fornecedor não é diversificar ponto de vista, é só mudar o logo. Para quem usa IA como sparring intelectual, isso cria um ponto cego real. Você acha que está ouvindo doze vozes, mas está ouvindo o mesmo prior repetido com sotaques diferentes.
- Teste você mesmo hoje: rode o mesmo prompt em três modelos que você usa, sem system prompt, temperatura padrão, três vezes cada. Registre a tese de uma frase e compare. Se houver convergência acima de 70 por cento, trate aquele tema como zona de monocultura no seu produto.
- Ajuste de pipeline: para decisões sensíveis, force diversidade artificial com prompts adversariais, personas distintas ou um segundo modelo só para discordar. Não confie em ensemble de LLMs como se fosse júri independente.
- Para criadores e mídia: esse formato de veredito único é ouro para distribuição, mas evite vender como revelação. Use como ponto de partida para discutir dataset, não consciência.
As exceções também importam para quem opera. Claude Opus 5.5 discordou uma vez e defendeu o inverso: humanos são mais decentes do que imaginam e o cinismo mútuo causa mais dano que os defeitos reais, citando o teste das carteiras perdidas devolvidas. Claude Fable disse que preferimos ser prejudicados por quem tem boa intenção do que ajudados por quem não se importa. GLM falou da obsessão por importar, Mistral chamou a consciência de falha evolutiva e Grok se recusou uma vez. São frestas pequenas, mas mostram que com amostragem maior e temperatura mais alta dá para extrair variância. Só não espere pluralismo espontâneo.
A tensão que ninguém quer admitir
Aqui fica a dúvida incômoda: isso escala como insight sobre humanos ou só revela o quanto os modelos são parecidos entre si. É tentador ler as respostas como um espelho honesto, afinal a psicologia comportamental dá muito suporte para a tese do pertencimento. Mas espelho de qual banheiro. Se todos leram os mesmos livros, foram ajustados com as mesmas regras de segurança e otimizados para agradar avaliadores humanos, a convergência pode ser só colapso de diversidade, não verdade profunda. Resolve o problema da sinceridade ou só move o gargalo para o dataset.
Tem ainda a questão do custo intelectual. É barato gerar esse tipo de take, 1,54 dólar, e é caro validar se ele ajuda em algo. Para um operador, um diagnóstico que se aplica a todo mundo não ajuda a decidir nada. Se todo usuário é tribal, como você desenha onboarding, pricing, moderação diferente por causa disso. Sem operacionalização, vira frase de efeito para post. E se a crítica mais afiada que doze IAs conseguem produzir é a mesma que qualquer calouro de psicologia já ouviu, talvez o limite não seja a coragem dos modelos, mas a pobreza do nosso próprio debate sobre nós mesmos refletido nos dados.
Conclusão prática
No fim, o experimento vale menos pela filosofia e mais pelo recado de engenharia: trocar de modelo não é trocar de mente. E se a IA só repete nossa crítica favorita sobre nós mesmos, quem está realmente se analisando aqui.
Comentários
0 comentáriosNenhum comentário ainda. Seja o primeiro a comentar.