
O banner que ninguém reconheceu
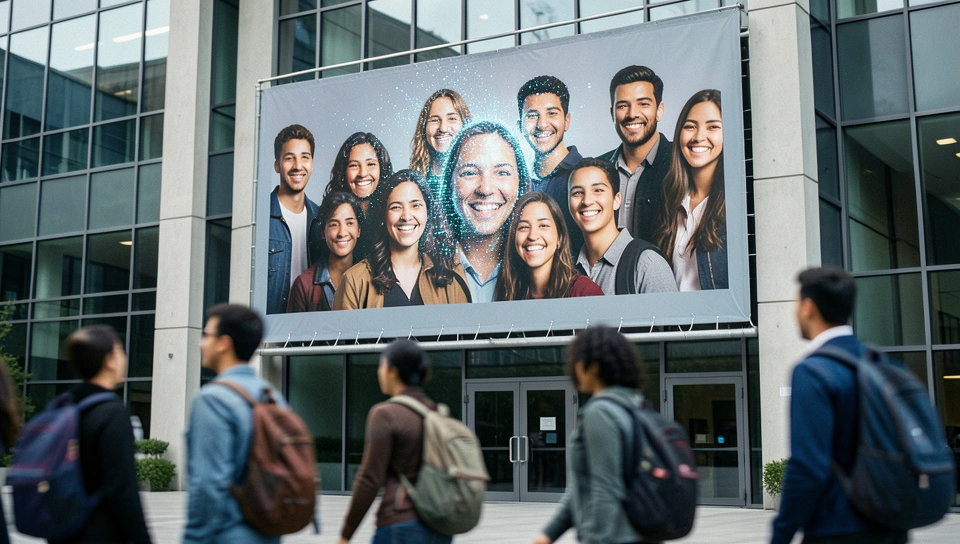
Um estudante de Stanford estava voltando de carro para o campus quando recebeu uma mensagem de um amigo. Era para ser um momento simples: ele aparecendo em um banner oficial da divisão de moradia e alimentação da universidade, a R&DE. Só que o rosto no banner não era o dele. No lugar onde ele deveria estar, a IA generativa usada para editar a peça tinha inserido uma mulher negra que nunca existiu. O nome dele é Billy Ramirez, turma de 2027, e a foto original tinha sido feita por um fotógrafo contratado pela própria universidade.
O caso parece anedota de internet, e de fato rendeu milhares de reações no Fizz, o aplicativo anônimo dos estudantes. Mas para quem trabalha com IA, o incômodo é outro. Não foi um deepfake amador ou um teste interno que vazou. Foi material publicitário oficial, publicado por uma das universidades mais ricas e vigiadas do mundo, com edição de raça, gênero e corpo feita sem consentimento e sem revisão aparente. Isso levanta a pergunta que todo operador conhece bem: onde estava a camada de verificação entre gerar e publicar.
O que Stanford fez
Pelo que foi apurado até agora, a R&DE usou uma ferramenta de edição por IA para alterar uma foto real de estudantes. Ramirez foi removido e substituído. Dois outros alunos ao lado dele tiveram o rosto afinado e o corpo visivelmente emagrecido. Não houve aviso, pedido de autorização ou explicação inicial. Ramirez disse que primeiro achou graça, depois se sentiu apagado. Nas palavras dele, em tradução livre, foi como ser silenciado e excluído de uma representação que deveria incluí-lo. E ele tem razão, porque diversidade fabricada não é inclusão, é cenografia.
A universidade ainda não detalhou qual ferramenta foi usada nem qual foi o fluxo de aprovação. O padrão desse tipo de incidente sugere algo simples e ainda mais preocupante: alguém recebeu a tarefa de ajustar o banner, talvez melhorar iluminação, cortar fundo ou padronizar rostos, e usou um editor com preenchimento generativo ou troca automática de pessoas. O resultado passou sem uma segunda checagem. Em operação de conteúdo, isso é falha básica de pipeline, não apenas erro criativo.
Como esse tipo de edição acontece na prática
Para entender como isso acontece, pense no fluxo típico de hoje. Você joga uma foto em um editor com IA, como um Photoshop com preenchimento generativo, Canva ou qualquer ferramenta de inpainting e outpainting. O modelo identifica áreas, sugere variações e reconstrói pixels com base em um prompt implícito ou automático. O custo é quase zero, centavos por imagem, e a latência é de segundos. Não há chamada de API complexa, não há avaliação de segurança, não há log de quem aprovou o quê. É exatamente por ser barato e rápido que esse tipo de erro passa.
Minha hipótese, e deixo claro que é inferência a partir de casos parecidos que já testei, é que houve uma combinação de retoque automático de beleza mais expansão ou troca de fundo. Muitas ferramentas vêm com filtros de embelezamento ativados por padrão, que afinam rosto, clareiam pele e alteram traços sem pedir. Se alguém ainda aplicou um comando do tipo tornar a imagem mais diversa ou otimizar para anúncio, o modelo completa com o estereótipo estatístico mais provável do seu dataset. O resultado é tecnicamente competente e operacionalmente desastroso: pixels corretos, contexto errado.
O que isso muda para quem opera IA
Quem constrói produto com IA precisa ler esse caso como alerta operacional. Quem ganha no curto prazo são as equipes de marketing que entregam mais rápido, com menos sessão de fotos e menos custo de produção. Quem perde são as pessoas retratadas, a marca e, no fim, a própria equipe, que agora precisa gerenciar crise. Se você usa IA para editar pessoas reais, a regra deveria ser simples: nada vai ao ar sem comparação lado a lado entre original e final, com aprovação humana registrada.
A ação prática aqui é montar uma trava mínima no seu fluxo. Guarde o arquivo original, gere uma versão com IA, e force um diff visual antes de publicar. Em time pequeno, isso pode ser uma pasta compartilhada com antes e depois e um check em duas etapas no Slack. Em time maior, vale bloquear a publicação se o hash da imagem final não estiver vinculado a um revisor. Parece burocracia, mas evita o que Stanford não evitou: publicar uma pessoa que não existe no lugar de uma pessoa real que confiou em você.
O problema não é só a ferramenta
E aqui entra a tensão que importa. Isso escala. Qualquer universidade, empresa ou agência hoje consegue gerar mil variações de campanha em uma tarde, testando rostos diferentes para públicos diferentes. O custo compensa, sem dúvida. Mas resolve ou só move o gargalo. Antes o gargalo era produção, agora é revisão, consentimento e responsabilidade. Se você automatiza a criação e mantém a revisão manual e apressada, você não ganhou eficiência, você só transferiu o risco para a ponta mais frágil, que é a reputação.
Tem outro ponto incômodo que ninguém quer admitir. A IA não inventou o viés, ela apenas executou uma ordem implícita com mais velocidade. Alguém, em algum momento, achou que aquele banner precisava parecer diferente. Mais diverso, mais magro, mais vendável. A ferramenta só entregou o que o operador sugeriu, mesmo sem prompt explícito. Quando terceirizamos esse julgamento para o modelo, perdemos o rastro da decisão. Depois fica impossível responder a pergunta básica: quem decidiu trocar aquele aluno e por quê.
Conclusão
No fim, Stanford trocou pixels e perdeu confiança. O conserto não é abandonar IA em publicidade, é tratar imagem gerada como código em produção: versionada, revisada e assinada por alguém. Fica a pergunta que vale para qualquer time: se amanhã um dos seus anúncios viralizar pelo motivo errado, você consegue mostrar o original, o prompt e quem aprovou.
Comentários
0 comentáriosNenhum comentário ainda. Seja o primeiro a comentar.